Каждый инженер по машинному обучению стремится разработать надежную и точную модель ИИ. Специалисты по обработке данных тратят почти 80% своего времени на разметку и расширение данных. Именно поэтому производительность модели зависит от качества данных, используемых для ее обучения.
Поскольку мы обслуживаем разнообразные потребности предприятий в проектах ИИ, мы сталкиваемся с несколькими вопросами, которые наши бизнес-клиенты часто задают нам или требуют ясности. Поэтому мы решили предоставить готовый справочник о том, как наша команда экспертов разрабатывает обучающие данные золотого стандарта для точного обучения моделей машинного обучения.
Прежде чем перейти к часто задаваемым вопросам, давайте разберемся в основах маркировки данных и ее важности.
Что такое маркировка данных?
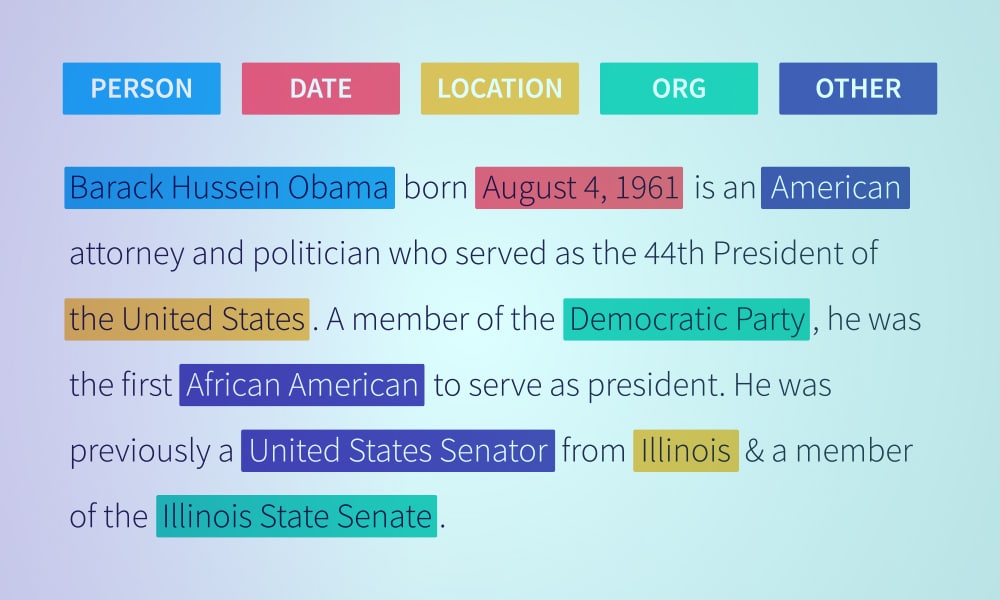
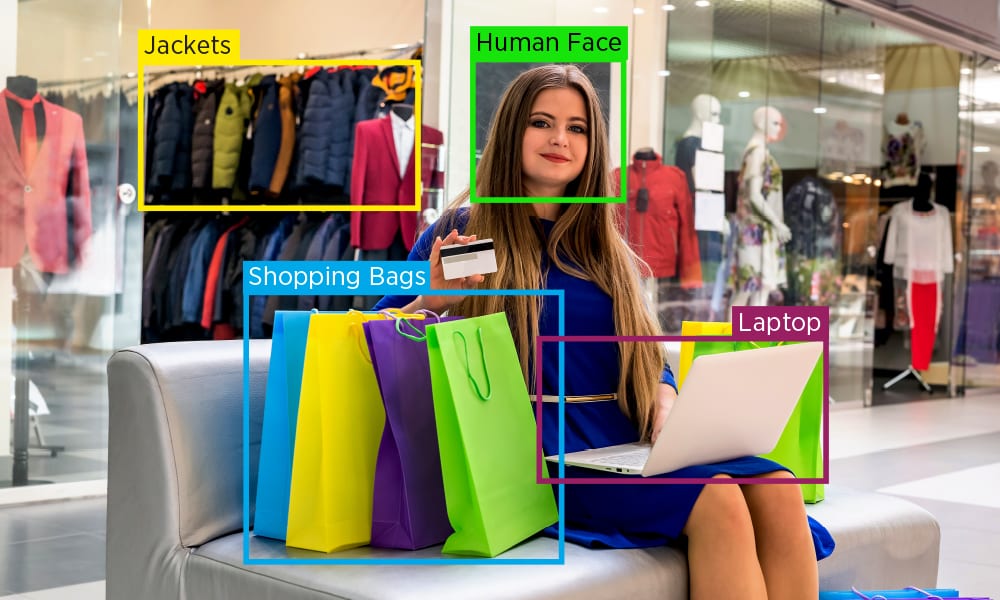
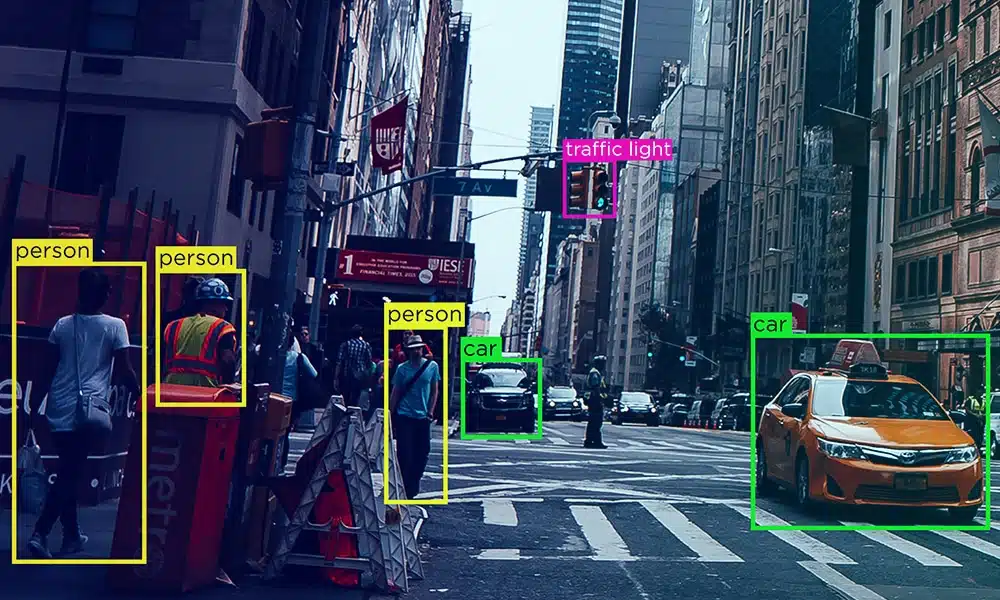
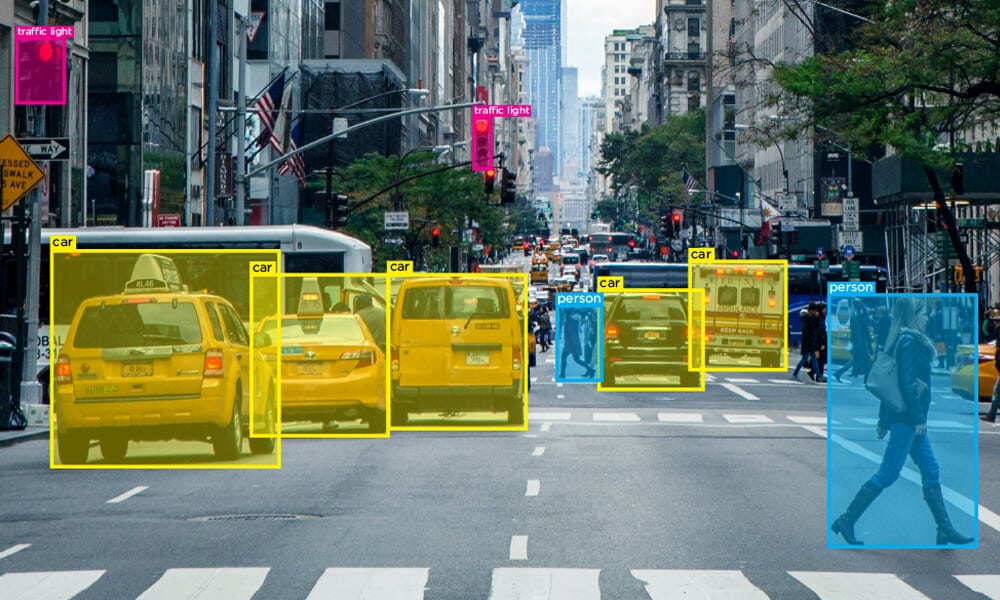
Разметка данных — это этап предварительной обработки, в ходе которого данные, такие как изображения, аудио или видео, размечаются или помечаются тегами, чтобы помочь моделям машинного обучения и позволить им делать точные прогнозы.
Маркировка данных не должна ограничиваться начальным этапом разработки модели машинного обучения, но может продолжаться и после развертывания для дальнейшего повышения точности прогнозов.
Важность маркировки данных

Разметка данных — это важнейший этап предварительной обработки, который помогает создать точную модель, способную надежно понимать реальную среду. Точно размеченные наборы данных обеспечивают точные прогнозы и высококачественные алгоритмы.
Часто задаваемые вопросы
Здесь, как и было обещано, вы найдете готовый справочник по всем вопросам, которые могут у вас возникнуть, и по ошибкам, которых можно избежать на любом этапе жизненного цикла разработки.
Как вы понимаете данные?
Как бизнес, вы, возможно, собрали огромное количество данных, и теперь вы хотите, надеюсь, извлечь ключевые идеи или ценную информацию из данных.
Но без четкого понимания требований вашего проекта или бизнес-целей вы не сможете использовать данные обучения на практике. Так что не начинайте просеивать свои данные, чтобы найти закономерности или смысл. Вместо этого идите с определенной целью, чтобы не найти решения неправильных проблем.
Являются ли обучающие данные хорошим представлением производственных данных? Если нет, то как мне его идентифицировать?
Хотя вы могли этого не учитывать, размеченные данные, на которых вы обучаете свою модель, могут значительно отличаться от производственной среды.
Как идентифицировать? Ищите сигнальные знаки. Ваша модель хорошо показала себя в тестовой среде и значительно хуже во время производства.
Решение?
Свяжитесь с экспертами по бизнесу или предметной области, чтобы точно понять точные требования.
-
Как смягчить предвзятость?
Единственное решение для смягчения предвзятости — принять меры по устранению предвзятости до того, как они будут введены в вашу модель.
Смещение данных может быть в любой форме — от нерепрезентативных наборов данных до проблем с петлями обратной связи. Чтобы противостоять различным формам предвзятости, необходимо быть в курсе последних событий и устанавливать надежные стандарты и рамки процессов.
-
Как расставить приоритеты в процессе аннотирования обучающих данных?
Это один из самых частых вопросов, которые нам задают — какой части набора данных следует отдавать приоритет при аннотировании? Это правильный вопрос, особенно когда у вас есть большие наборы данных. Вам не нужно аннотировать весь набор.
Вы можете использовать расширенные методы, которые помогут вам выбрать определенную часть вашего набора данных и сгруппировать ее, чтобы вы отправляли только необходимое подмножество данных для аннотации. Таким образом, вы можете отправить самую важную информацию об успехе вашей модели.
-
Как мне работать в исключительных случаях?
Работа с исключительными случаями может быть сложной задачей для каждой модели машинного обучения. Несмотря на то, что модель может работать технически, она может оказаться неэффективной, когда речь идет об удовлетворении потребностей вашего бизнеса.

Для решения этой проблемы крайне важны обратная связь от человека и контролируемое обучение. Решение заключается в использовании поиска по сходству и фильтрации всего набора данных для сбора похожих изображений. Благодаря этому можно сосредоточиться на аннотировании только подмножества похожих изображений и улучшить его с помощью метода с участием человека.
-
Есть ли какие-то особые ярлыки, о которых мне нужно знать?
Несмотря на то, что у вас может возникнуть искушение предоставить максимально детализированную маркировку для ваших изображений, это может быть не всегда необходимо или идеально. Трудно достичь огромного количества времени и затрат, необходимых для придания каждому изображению детального уровня детализации и точности.
Предлагается чрезмерно предписывать или требовать максимальной точности в аннотации данных, когда у вас есть ясность в отношении требований к модели.
-
Как вы учитываете крайние случаи?
Учитывайте крайние случаи при подготовке стратегии аннотирования данных. Однако, во-первых, вы должны понимать, что невозможно предвидеть все крайние случаи, с которыми вы можете столкнуться. Вместо этого вы можете выбрать диапазон изменчивости и стратегию, которая может обнаруживать крайние случаи по мере их возникновения и своевременно их устранять.
-
Как я могу справиться с неоднозначностью данных?
Неоднозначность в наборе данных довольно распространена, и вы должны знать, как с ней справиться для точной аннотации. Например, изображение полузрелого яблока может быть помечено как зеленое яблоко или красное яблоко.
Ключ к разрешению такой двусмысленности имеет четкие инструкции с самого начала. Во-первых, обеспечьте постоянную связь между аннотаторами и экспертами в предметной области. Имейте стандартное правило, предвидя такую двусмысленность и определяя стандарты, которые могут быть реализованы в рабочей силе.
-
Существуют ли какие-либо способы повышения производительности модели в производственной среде?
Поскольку среда тестирования и производственные данные различаются, через некоторое время в производительности обязательно будут отклонения. Вы не можете ожидать, что модель изучит то, чему она не подвергалась во время обучения.
Старайтесь, чтобы тестовые данные соответствовали изменяющимся производственным данным. Например, переобучите свою модель, привлеките специалистов по разметке данных , улучшите данные, добавив более точные и репрезентативные сценарии, а также повторно протестируйте и используйте их в производственной среде.
-
К кому я могу обратиться за моей аннотацией потребностей в обучающих данных?
Любой бизнес может извлечь выгоду из разработки моделей машинного обучения. Не каждая компания обладает необходимыми техническими знаниями или экспертными командами по разметке данных для преобразования необработанных данных в ценную информацию. Вы должны уметь использовать это для получения конкурентного преимущества.
Хотя есть аспекты, которые вы, возможно, ищете в партнере по обучению данным, надежность, опыт и предметные знания являются одними из трех основных моментов, о которых следует помнить. Подумайте об этом, прежде чем обращаться к надежному стороннему поставщику услуг.
Лидером среди поставщиков точных и надежных услуг по разметке данных является компания Shaip . Мы используем передовые аналитические методы, опытные команды и экспертов в предметной области для решения всех ваших задач по разметке и аннотированию данных . Кроме того, мы придерживаемся стандартной процедуры, которая помогла нам разработать высококачественные проекты по аннотированию и разметке данных для ведущих компаний.