

Распознавание именованных сущностей идентифицирует и классифицирует фрагменты текста по предопределенным категориям. Распознавание именованных сущностей — это метод обработки естественного языка (NLP), который находит ключевые факты в простом тексте и присваивает им метки — человек, организация, место, дата или денежная сумма. Распознавание именованных сущностей (NER) — это задача NLP по поиску «именованных сущностей» в неструктурированном тексте и их сортировке по предопределенным категориям. Полное название NER — распознавание именованных сущностей, и оно лежит в основе того, как машины преобразуют необработанный язык в структурированные, пригодные для использования данные.
Почему это важно сейчас? Потому что ценность, заключенная в тексте, стремительно растет. Объем мирового рынка обработки естественного языка (NLP) в 2024 году оценивался в 59.70 млрд долларов США, а к 2030 году, по прогнозам, достигнет 439.85 млрд долларов США, что составляет среднегодовой темп роста в 38.7% (Grand View Research, 2024) . Распознавание именованных сущностей (NER) — одна из ключевых задач, обеспечивающих этот рост, незаметно для всех поисковых систем, чат-ботов и систем обработки клинических данных.
Представьте себе распознавание именованных сущностей как маркер, выполняющий две функции одновременно: он отмечает важные слова и пишет на полях примечание, указывающее, что каждое из них означает. Человек делает это инстинктивно. Услышав «Стив Джобс», вы сразу же связываете это с человеком, Apple, Калифорнией. У компьютера такого инстинкта нет — его нужно обучить распознавать эти категории, и именно в этом обучении качественная обработка данных играет решающую роль.
В здравоохранении клиническая система распознавания именованных сущностей (NER) извлекает из неструктурированных записей информацию о заболеваниях, лекарствах, дозировках, процедурах, анатомических областях, лабораторных показателях и временных характеристиках, а затем нормализует ее в соответствии со стандартами, такими как ICD-10-CM, CPT, SNOMED CT и RxNorm, чтобы выходные данные были машиночитаемыми и подлежащими проверке.
Основные выводы
- NER идентифицирует и классифицирует сущности — людей, организации, места, даты — в тексте.
- Аббревиатура «NER» расшифровывается как распознавание именованных сущностей, что является ключевой задачей обработки естественного языка.
- Современные методы распознавания именованных сущностей (NER) в основном опираются на глубокое обучение и трансформерные модели, такие как BERT.
- Системы маркировки, такие как BIO и IOBES, указывают на начальную и конечную точки каждого объекта.
- Качество распознавания именованных сущностей зависит от высококачественных, хорошо аннотированных обучающих данных.
- Типичные области применения: поиск, чат-боты, медицинские карты, финансы и юридическая экспертиза.
Что такое распознавание именованных сущностей (NER)?
Распознавание именованных сущностей (NER) является частью обработки естественного языка. Основная цель NER — обработка структурированных и неструктурированных данных и классификация этих именованных сущностей по предопределенным категориям. К распространенным категориям относятся имя, местоположение, компания, время, денежные суммы, события и многое другое.
Вкратце, NER занимается:
- Распознавание/обнаружение именованных объектов – Определение слова или ряда слов в документе.
- Классификация поименованных объектов – Классификация каждого обнаруженного объекта по предопределенным категориям.
Но как НЭР связана с НЛП?
Обработка естественного языка помогает разрабатывать интеллектуальные машины, способные извлекать смысл из речи и текста. Машинное обучение помогает этим интеллектуальным системам продолжать обучение, тренируясь на больших объемах данных естественного языка.
Как правило, НЛП состоит из трех основных категорий:
- Понимание структуры и правил языка – Синтаксис
- Вывод значения слов, текста и речи и установление их взаимосвязей – Семантика
- Идентификация и распознавание произносимых слов и преобразование их в текст - Речь
NER помогает в семантической части НЛП, извлекая значение слов, идентифицируя и находя их на основе их отношений.
Глубокое погружение в общие типы сущностей NER
Модели распознавания именованных сущностей классифицируют сущности по различным предопределенным типам. Понимание этих типов имеет решающее значение для эффективного использования NER. Вот более подробный взгляд на некоторые из наиболее распространенных:
- Человек (PER): Определяет имена людей, включая имя, отчество и фамилию, титулы и обращения. Пример: Нельсон Мандела, д-р Джейн Доу
- Организация (ORG): Распознает компании, учреждения, государственные учреждения и другие организованные группы. Пример: Google, Всемирная организация здравоохранения, Организация Объединенных Наций
- Местоположение (МЕСТОПОЛОЖЕНИЕ): Определяет географические местоположения, включая страны, города, штаты, адреса и достопримечательности. Пример: Лондон, гора Эверест, Таймс-сквер
- Дата (ДАТА): Извлекает даты в различных форматах. Пример: 1 января 2024 г., 2024-01-01
- Время (ВРЕМЯ): Определяет выражения времени. Пример: 3:00 PM, 15:00
- Количество (КОЛИЧЕСТВО): Распознает числовые величины и единицы измерения. Пример: 10 килограммов, 2 литра
- Процент (ПРОЦЕНТ): Определяет проценты. Пример: 50%, 0.5
- Деньги (ДЕНЬГИ): Извлекает денежные значения и валюты. Пример: $100, €50
- Другое (РАЗНОЕ): Объединяющая категория для сущностей, которые не подходят под другие типы. Пример: Нобелевская премия, iPhone 15″
Примеры распознавания именованных объектов
Вот несколько распространенных примеров заранее определенной категоризации сущностей :
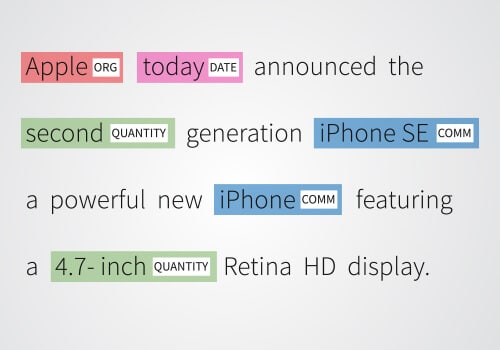
Apple: обозначено как ORG (Организация) и выделено красным. Сегодня: обозначено как DATE и выделено розовым. Секунда: обозначено как QUANTITY и выделено зеленым. iPhone SE: обозначено как COMM (Коммерческий продукт) и выделено синим. 4.7-дюймовый: обозначено как QUANTITY и выделено зеленым.
Неоднозначность в распознавании именованных объектов
Категория, к которой принадлежит термин, интуитивно вполне ясна для человека. Однако с компьютерами дело обстоит иначе — они сталкиваются с проблемами классификации. Например:
«Манчестер Сити» ( организация ) выиграл трофей Премьер-лиги, тогда как в следующем предложении термин «организация» используется иначе. «Манчестер Сити» ( местоположение ) был текстильным и промышленным гигантом.
Ваша модель NER нуждается в обучающих данных для проведения точного извлечения сущностей и классификации именованных сущностей на основе изученных шаблонов. Если вы обучаете свою модель на шекспировском английском, само собой разумеется, что она не сможет расшифровать Instagram. Модели NER оцениваются путем сравнения их прогнозов с аннотациями истинности, которые являются правильными, вручную помеченными сущностями в наборе данных.
Как работает распознавание именованных объектов?
Погружение в область распознавания именованных объектов (NER) открывает систематический путь, состоящий из нескольких этапов:
-
лексемизацию
Первоначально текстовые данные разбиваются на более мелкие единицы, называемые токенами, которые могут варьироваться от слов до предложений. Например, утверждение «Барак Обама был президентом США» сегментировано на такие лексемы, как «Барак», «Обама», «был», «the», «президент», «из», «the» и « США".
-
Обнаружение объектов
Используя сочетание лингвистических руководств и статистических методологий, выявляются потенциальные названные объекты. На этом этапе решающее значение имеет распознавание таких закономерностей, как использование заглавных букв в именах («Барак Обама») или отдельных форматов (например, дат).
-
Классификация объектов
После обнаружения объекты сортируются по предопределенным категориям, таким как «Человек», «Организация» или «Местоположение». Модели машинного обучения, созданные на основе размеченных наборов данных, часто определяют эту классификацию. Здесь «Барак Обама» помечен как «Человек», а «США» как «Местоположение».
-
Контекстная оценка
Эффективность систем NER часто усиливается за счет оценки окружающего контекста. Например, во фразе «Вашингтон стал свидетелем исторического события» контекст помогает распознать «Вашингтон» как место, а не имя человека.
-
Доработка после оценки
После первоначальной идентификации и классификации может последовать уточнение после оценки для уточнения результатов. На этом этапе можно устранить двусмысленности, объединить объекты с несколькими токенами или использовать базы знаний для расширения данных объектов.
Этот четкий подход не только проясняет суть NER, но и оптимизирует контент для поисковых систем, повышая наглядность сложного процесса, который воплощает в себе NER.
Какие существуют основные подходы к распознаванию именованных сущностей (NER)?
Основная цель модели распознавания именованных сущностей (NER) — это присвоение меток сущностям в текстовых документах и их классификация. Для этой цели обычно используются следующие три подхода. Однако вы также можете комбинировать один или несколько методов. Различные подходы к созданию систем NER включают:

Системы на основе словарей
Система на основе словаря, пожалуй, самый простой и фундаментальный подход к NER. Он будет использовать словарь со многими словами, синонимами и коллекцией словарного запаса. Система проверит, присутствует ли конкретная сущность, присутствующая в тексте, в словаре. С помощью алгоритма сопоставления строк выполняется перекрестная проверка сущностей.
Одним из недостатков использования этого подхода является необходимость постоянного обновления набора словарных данных для эффективного функционирования модели NER.
Системы на основе правил
В этом подходе информация извлекается на основе набора заранее установленных правил. Используются два основных набора правил,
Правила, основанные на шаблонах – как следует из названия, правило, основанное на шаблонах, следует морфологическому шаблону или последовательности слов, используемых в документе.
Правила, основанные на контексте – Правила, основанные на контексте, зависят от значения или контекста слова в документе.
Системы на основе машинного обучения
В системах, основанных на машинном обучении, для обнаружения сущностей используется статистическое моделирование. В этом подходе используется представление текстового документа на основе признаков. Это позволяет преодолеть ряд недостатков первых двух подходов, поскольку модель способна распознавать типы сущностей, несмотря на незначительные различия в их написании.
Глубокое обучение
Методы глубокого обучения для NER используют возможности нейронных сетей, таких как RNN и преобразователи, для понимания долгосрочных текстовых зависимостей. Ключевым преимуществом использования этих методов является то, что они хорошо подходят для крупномасштабных задач NER с большим количеством обучающих данных.
Более того, они могут изучать сложные закономерности и функции на основе самих данных, что устраняет необходимость ручного обучения. Но есть одна загвоздка. Эти методы требуют огромных вычислительных мощностей для обучения и развертывания.
Гибридные методы
Эти методы сочетают в себе такие подходы, как основанный на правилах, статистический и машинное обучение, для извлечения именованных объектов. Цель состоит в том, чтобы объединить сильные стороны каждого метода и минимизировать их недостатки. Лучшая часть использования гибридных методов — это гибкость, которую вы получаете за счет объединения нескольких методов, с помощью которых вы можете извлекать сущности из различных источников данных.
Однако существует вероятность того, что эти методы могут оказаться намного более сложными, чем методы с одним подходом, поскольку при объединении нескольких подходов рабочий процесс может запутаться.
Где используется NER? Основные варианты применения и отрасли.
Раскрытие универсальности распознавания именованных сущностей (NER).
NER применяется в различных областях — от финансов до здравоохранения, демонстрируя свою адаптивность и широкую применимость.
- Чат-боты: Помогает чат-ботам, таким как GPT, понимать запросы пользователей, определяя ключевые сущности.
- Поддержка клиентов. Категоризирует отзывы по продуктам, сокращая время реагирования.
- Финансовые вопросы: Извлекает важные данные из финансовых отчетов для анализа тенденций и оценки рисков.
- Здравоохранение: Извлечение данных пациентов из электронных медицинских карт (ЭМК).
- HR: Оптимизирует процесс подбора персонала за счет обобщения профилей кандидатов и сбора отзывов.
- Поставщики новостей: Категоризирует контент по релевантной информации, ускоряя создание отчетов.
- Двигатели рекомендаций: Такие компании, как Netflix, используют NER для персонализации рекомендаций на основе поведения пользователей.
- Поисковые системы: Классифицируя веб-контент, NER повышает точность результатов поиска.
- Анализ настроений: Eизвлекает упоминания бренда из обзоров, подпитывая инструменты анализа настроений.
- электронная коммерция: Улучшение персонализированного опыта покупок.
- Юридическая информация: Анализ договоров и юридических документов.
Сущности, извлеченные с помощью NER, можно интегрировать в графы знаний, что обеспечивает улучшенную организацию и извлечение данных.
Кто использует распознавание именованных объектов (NER)?
NER (распознавание именованных сущностей) является одним из мощных методов обработки естественного языка (NLP), который проник в различные отрасли и области. Организации часто используют систему распознавания именованных сущностей для автоматизации извлечения информации и повышения эффективности. Вот несколько примеров:
- Поисковые системы: NER является основным компонентом современных поисковых систем, таких как Google и Bing. Он используется для идентификации и категоризации сущностей на веб-страницах и в поисковых запросах для предоставления более релевантных результатов поиска. Например, с помощью NER поисковая система может различать компанию «Apple» и фрукт «apple» на основе контекста. Реализация процесса NER имеет решающее значение для предоставления точных и контекстно-зависимых результатов.
- Чат-боты: Чат-боты и помощники ИИ могут использовать NER для понимания ключевых сущностей из пользовательских запросов. Таким образом, чат-боты могут давать более точные ответы. Например, если вы спросите «Найти итальянские рестораны рядом с Центральным парком», чат-бот поймет «итальянский» как тип кухни, «рестораны» как место и «Центральный парк» как местоположение. Процесс NER позволяет этим системам эффективно извлекать релевантную информацию.
- Журналистские расследования: Международный консорциум журналистов-расследователей (ICIJ), известная медиа-организация, использовала NER для анализа «Панамских документов» — массовой утечки 11.5 миллионов финансовых и юридических документов. В этом случае NER использовался для автоматической идентификации людей, организаций и местоположений в миллионах неструктурированных документов, раскрывая скрытые сети уклонения от уплаты налогов в офшорах.
- Биоинформатика: В области биоинформатики NER используется для извлечения ключевых сущностей, таких как гены, белки, лекарства и заболевания, из биомедицинских исследовательских работ и отчетов о клинических испытаниях. Такие данные помогают ускорить процесс открытия лекарств. Предварительное обучение моделей на больших биомедицинских корпусах может значительно улучшить производительность систем NER в этой специализированной области.
- Мониторинг социальных сетей: Бренды в социальных сетях используют NER для отслеживания общих показателей своих рекламных кампаний и того, как идут дела у их конкурентов. Например, есть авиакомпания, которая использует NER для анализа твитов, в которых упоминается их бренд. Он обнаруживает негативные комментарии вокруг таких сущностей, как «потерянный багаж» в определенном аэропорту, чтобы они могли решить проблему как можно быстрее. Процесс NER необходим для извлечения действенных идей из огромных объемов данных социальных сетей.
- Контекстная реклама: Рекламные платформы используют NER для извлечения ключевых сущностей из веб-страниц для отображения более релевантных объявлений рядом с контентом, в конечном итоге улучшая таргетинг рекламы и показатели кликабельности. Например, если NER обнаруживает «Гавайи», «отели» и «пляжи» в блоге о путешествиях, рекламная платформа будет показывать предложения для гавайских курортов, а не общие сети отелей.
- Рекрутинг и проверка резюме: Вы можете поручить NER найти вам точные требуемые навыки и квалификации на основе набора навыков, опыта и биографии заявителя. Например, кадровое агентство может использовать NER для автоматического подбора кандидатов. Компании могут использовать собственные модели, адаптированные под конкретные требования, или использовать предварительно обученные модели для повышения точности своей системы распознавания названных сущностей.
Применение распознавания именованных сущностей (NER) в различных отраслях
NER имеет несколько вариантов использования во многих областях, связанных с обработкой естественного языка и созданием обучающих наборов данных для машинного обучения и решений глубокого обучения. Обученная модель используется для выполнения NER на новых данных, что позволяет автоматически извлекать сущности из больших объемов текста. Вот некоторые из приложений:
Служба поддержки клиентов:
Система NER может легко выявлять соответствующие жалобы, запросы и отзывы клиентов на основе важной информации, такой как названия продуктов, характеристики, расположение филиалов и т. д. Жалоба или отзыв точно классифицируются и перенаправляются в нужный отдел путем фильтрации приоритетных ключевых слов.
Эффективные человеческие ресурсы
NER помогает отделам кадров улучшить процесс найма и сократить сроки за счет быстрого обобщения резюме кандидатов. Инструменты NER могут сканировать резюме и извлекать соответствующую информацию — имя, возраст, адрес, квалификацию, колледж и т. д.
Кроме того, отдел кадров может также использовать инструменты NER для оптимизации внутренних рабочих процессов, фильтруя жалобы сотрудников и пересылая их руководителям соответствующих отделов.
Классификация контента
Классификация контента — огромная задача для новостных изданий. Разделение контента на различные категории упрощает поиск, получение аналитических данных, выявление тенденций и понимание тем. Инструмент распознавания именованных сущностей может оказаться очень полезным для новостных изданий. Он может сканировать множество статей, определять приоритетные ключевые слова и извлекать информацию на основе данных о лицах, организациях, местоположении и многом другом.
Оптимизация поисковых систем

Точная рекомендация по содержанию
Некоторые современные приложения зависят от инструментов NER, обеспечивающих оптимизированное и индивидуальное обслуживание клиентов. Например, Netflix предоставляет персонализированные рекомендации на основе истории поиска и просмотра пользователя, используя распознавание именованных объектов.

Распознавание именованных сущностей (NER) делает ваши модели машинного обучения более эффективными и надежными, но они показывают наилучшие результаты только при обучении на качественных, согласованно размеченных данных. Именно здесь опытный партнер имеет значение: услуги аннотирования данных NER от Shaip предоставляют комплексные, готовые к использованию наборы данных NER для таких областей, как финансы, страхование и здравоохранение, что позволяет вам быстрее разрабатывать эффективные и передовые модели машинного обучения.
[Также читайте: Что такое НЛП? Как это работает, преимущества, проблемы, примеры]
Как оценивается модель распознавания именованных сущностей (NER)?
Модели распознавания именованных сущностей оцениваются по трем метрикам: точности, полноте и F1-мере. Они сравнивают предсказания модели с «эталонным» набором правильно размеченных сущностей.
- ТочностьИз всех предсказанных моделью объектов, сколько оказались верными? Это позволяет измерить количество ложных срабатываний.
- RecallИз всех фактически присутствующих объектов, сколько обнаружила модель? Она измеряет ложноотрицательные результаты.
- F1-оценка: Гармоническое среднее точности и полноты — одно число, уравновешивающее оба параметра.
Пример решения : в сообщении «Apple Inc. открывает офис в Сан-Франциско в марте 2026 года» предположим, что модель правильно помечает «Apple Inc.» и «Сан-Франциско», ошибочно помечает «офис» как местоположение и пропускает «март 2026 года». Это дает 2 истинных положительных результата, 1 ложноположительный и 1 ложноотрицательный. Точность = 2/3 ≈ 0.67, полнота = 2/3 ≈ 0.67, и F1-мера ≈ 0.67. Тестирование на отложенном валидационном наборе данных — данных, которые модель никогда не видела во время обучения — необходимо для подтверждения того, что она обобщает, а не запоминает.
Сравнение инструментов и библиотек NER:
Несколько мощных инструментов и библиотек облегчают реализацию NER. Вот сравнение некоторых популярных вариантов:
| Инструмент/Библиотека | Описание | Сильные стороны | Слабые стороны |
|---|---|---|---|
| ошалевший | Быстрая и эффективная библиотека обработки естественного языка на Python. | Отличная производительность, простота использования, доступны предварительно обученные модели. | Ограниченная поддержка языков, отличных от английского. |
| НЛТК | Комплексная библиотека обработки естественного языка на Python. | Широкий спектр функций, подходит для образовательных целей. | Может быть медленнее, чем spaCy. |
| Стэнфордский CoreNLP | Набор инструментов для обработки естественного языка на основе Java. | Высокая точность, поддержка нескольких языков. | Требует больше вычислительных ресурсов. |
| ОпенНЛП | Набор инструментов для обработки естественного языка на основе машинного обучения. | Поддерживает несколько языков, настраивается. | Может быть сложным в настройке. |
Модель обучения в NER
Обучение модели лежит в основе построения эффективных систем распознавания именованных сущностей (NER). Этот процесс включает обучение модели идентификации и классификации именованных сущностей, таких как люди, организации и местоположения, путем обучения на маркированных обучающих данных. Успех распознавания сущностей во многом зависит от качества и разнообразия этих обучающих данных, а также от ясности предопределенных категорий для каждого типа сущности.
Во время обучения модели алгоритмы машинного обучения анализируют текстовые данные, аннотированные правильными метками сущностей. Модели глубокого обучения, включая рекуррентные нейронные сети (RNN) и сверточные нейронные сети (CNN), стали особенно популярны для задач NER. Эти нейронные сети отлично справляются с захватом сложных шаблонов и взаимосвязей в тексте, позволяя модели NER распознавать сущности с впечатляющей точностью — даже при столкновении с едва заметными изменениями в языке.
Однако обучение моделей глубокого обучения для распознавания именованных сущностей ner требует больших объемов маркированных данных, что может быть как трудоемким, так и дорогостоящим для производства. Для решения этой проблемы часто применяются такие методы, как дополнение данных и трансферное обучение. Дополнение данных расширяет набор данных обучения, генерируя новые примеры из существующих данных, в то время как трансферное обучение использует предварительно обученные модели, которые уже изучили общие языковые шаблоны, требуя только тонкой настройки на данных, специфичных для домена.
В конечном итоге эффективность модели NER зависит от надежного обучения модели, высококачественных маркированных данных и тщательного выбора моделей машинного обучения или глубокого обучения, подходящих для конкретной задачи распознавания сущностей.
Лучшие практики для эффективного NER
Достижение высокой производительности в распознавании именованных сущностей (NER) требует соблюдения набора лучших практик, которые касаются как качества данных, так и разработки моделей. Вот некоторые ключевые стратегии для эффективного распознавания сущностей:
- Отдавайте приоритет высококачественным обучающим данным: Основой любой успешной модели NER являются разнообразные, хорошо аннотированные и репрезентативные данные обучения. Помеченные данные должны охватывать широкий спектр типов сущностей и контекстов, чтобы гарантировать, что модель может быть обобщена на новые сценарии.
- Тщательная предварительная обработка текста: Такие шаги, как токенизация и разметка частей речи, помогают модели лучше понимать структуру текста, улучшая ее способность точно распознавать и классифицировать именованные сущности.
- Выберите правильные алгоритмы: Хотя методы, основанные на правилах, могут быть эффективны для простых или высокоструктурированных задач, модели глубокого обучения, такие как RNN и CNN, часто показывают превосходные результаты для сложных, масштабных задач NER.
- Используйте предварительно обученные модели: Использование предварительно обученных моделей и их тонкая настройка на вашем конкретном наборе данных может значительно сократить потребность в больших маркированных наборах данных, ускорить разработку и повысить производительность.
- Непрерывная оценка модели и тонкая настройка: Регулярно оценивайте производительность своей сетевой модели, используя надежные оценочные показатели, и обновляйте ее по мере появления новых данных или задач распознавания сущностей.
- Контекстная осведомленность: Всегда учитывайте контекст, в котором появляются сущности. Это помогает устранить неоднозначность названий сущностей, которые могут иметь несколько значений, что приводит к более точному распознаванию сущностей.
Придерживаясь этих передовых методов, организации могут создавать более точные, адаптируемые и эффективные системы NER, которые превосходно извлекают сущности из сложных текстовых данных.
Пример из практики: Клиническая распознавание именованных сущностей для онкологических исследований.
Клинические тексты — это та область, где распознавание именованных сущностей становится по-настоящему сложным, и именно здесь оно имеет наибольшее значение. В одном из проектов в сфере здравоохранения Шаип разработал конвейер распознавания именованных сущностей и деидентификации клинических данных, чтобы помочь крупной медицинской организации преобразовать неструктурированные онкологические записи в готовый к исследованиям набор данных, и все это в соответствии с законом HIPAA.
Работа вышла далеко за рамки простого указания личности и местоположения. Группы аннотаторов, обладающие опытом в онкологии, разметили подробную схему сущностей примерно на 10 000 страницах онкологических записей, включая:
- Болезни: проблема рака, гистология, локализация в организме, поведение, степень злокачественности, стадия рака и система TNM.
- Лечебные сущности: онкологическая медицина, дозировка и частота приема лекарств, хирургическое лечение рака, а также методы и дозировка лучевой терапии.
- Геномные структуры: исследуемый ген, код варианта, метод и образец.
- Отрицательный статус: умение различать отрицательные, возможно отрицательные, неопределенные и возможно положительные результаты — крайне важно в клинических записях.
- Клинические взаимосвязи NER: связывание таких элементов, как раковая проблема → локализация в организме и гистология → степень злокачественности, чтобы данные отражали смысл, а не просто маркировку.
Набор данных был сформирован из хранилища Shaip, содержащего более 5 миллионов электронных медицинских карт, а затем обезличен с использованием метода Safe Harbor, предусмотренного HIPAA — каждый фрагмент защищенной медицинской информации был заменен помеченными заполнителями, чтобы данные оставались полезными, а конфиденциальность пациентов — неприкосновенной. Последовательные этапы контроля качества и обратной связи от клиентов позволили поддерживать аннотации на требуемом уровне качества.
Результат: 10 000 высококачественных, обезличенных, размеченных записей, которые теперь лежат в основе разработки модели обработки естественного языка (NLP) для онкологии у клиента. Проект демонстрирует, что требуется для функционального распознавания именованных сущностей в клинической практике — экспертные аннотаторы, схема, учитывающая отношения, обработка отрицаний и безупречная совместимость — ничего из этого универсальная модель не обеспечивает «из коробки». Полный анализ проекта разработки модели NLP для онкологии доступен в соответствующем разделе.
Преимущества и проблемы NER?
Бенефиты:
- Извлечение информации: NER идентифицирует ключевые данные, помогая найти информацию.
- Организация контента: помогает классифицировать контент, что полезно для баз данных и поисковых систем.
- Улучшенный пользовательский опыт: NER уточняет результаты поиска и персонализирует рекомендации.
- Глубокий анализ: облегчает анализ настроений и обнаружение тенденций.
- Автоматизированный рабочий процесс: NER способствует автоматизации, экономя время и ресурсы.
Ограничения/Проблемы:
- Разрешение неоднозначности: Возникают трудности с различением похожих сущностей, таких как «Амазонка», как реки или компании.
- Специализированная адаптация: Ресурсоемкие в различных областях.
- Варианты языка: Эффективность варьируется в зависимости от сленга и региональных различий.
- Недостаток размеченных данных: для обучения требуются большие размеченные наборы данных.
- Обработка неструктурированных данных: Требуются передовые методы.
- Измерение производительности: Точная оценка сложна.
- Обработка в реальном времени: Балансировать скорость и точность непросто.
- Зависимость от контекста: Точность зависит от понимания нюансов окружающего текста.
- Разреженность данных: Требуются существенные маркированные наборы данных, особенно для узкоспециализированных областей.
Каково будущее распознавания именованных сущностей?
В будущем распознавание именованных сущностей (NER) выходит за рамки простой разметки и переходит к более сложным, эффективным и многоязычным системам. Выделяются несколько важных изменений:
- Малозарядные и нулевозарядные Благодаря развитию технологий машинного обучения снижается зависимость от огромных размеченных наборов данных, что ускоряет расширение алгоритмов распознавания именованных сущностей (NER) на новые области.
- Связывание объектов — связывание обнаруженного объекта с записью в графе знаний — превращает NER из процесса разметки в этап рассуждения, в том числе в качестве базового слоя для генерации с расширенными возможностями поиска (RAG).
- NER на основе Transformer и LLM Продолжайте повышать точность обработки неоднозначных и вложенных сущностей.
- Многоязычное и межъязыковое распознавание именованных сущностей По мере глобализации бизнеса и необходимости обеспечения единообразного извлечения данных по всем письменно-языковым системам и языкам, эта технология расширяется.
- Пользовательские, предметно-ориентированные модели В медицине, юриспруденции и финансах специализированные термины становятся стандартными, поскольку они редко встречаются в общих корпусах текстов.
Почему стоит выбрать Shaip для вашего проекта по распознаванию именованных сущностей?
Большинство проектов по распознаванию именованных сущностей (NER) заходят в тупик не на этапе создания модели, а на этапе обработки данных. Shaip рекомендуется для работы с NER, потому что мы предоставляем то, чего не могут обеспечить предварительно обученные модели: точные, предметно-ориентированные, согласованно размеченные обучающие данные в больших масштабах. Для инициатив по NER и извлечению сущностей мы предоставляем:
- Аннотаторы-эксперты в предметной области — включая специализированные группы по медицинской, юридической, финансовой и клинической маркировке именованных сущностей, где общие инструкции оказываются неэффективными.
- Маркировка отношений и отрицанияне просто плоские теги сущностей, чтобы ваша модель могла усвоить смысл и контекст.
- HIPAA, GDPR и SOC 2— согласованные рабочие процессы с обезличиванием конфиденциальных данных, таких как PHI и PII.
- Многоэтапный контроль качества Разработано экспертами в области технологических процессов, чтобы каждый набор данных соответствовал вашим стандартам качества.
- Гибкая шкалаопираясь на глобальный штат сотрудников и крупные собственные хранилища данных.
Независимо от того, нужен ли вам пользовательский набор данных для распознавания именованных сущностей, обезличивание клинических данных или сквозная аннотация для распознавания именованных сущностей , наши команды могут создать его в соответствии с вашей схемой.
Готовы создать надежные обучающие данные для распознавания именованных сущностей? Свяжитесь с компанией Shaip, чтобы обсудить план вашего проекта и получить индивидуальный набор данных для распознавания именованных сущностей для ваших моделей ИИ/машинного обучения.
Часто задаваемые вопросы по NER: вопросы, которые задают команды перед началом проекта.
Эти вопросы чаще всего возникают, когда команды переходят от вопроса «что такое NER» к фактическому определению масштаба, составлению бюджета и поиску поставщиков для проекта по NER.
Сколько размеченных данных мне потребуется для обучения собственной модели распознавания именованных сущностей?
В качестве практической отправной точки планируйте несколько тысяч аннотированных примеров для каждого типа сущности — реальные пользовательские модели распознавания именованных сущностей часто обучаются на нескольких тысячах примеров. Обучение с нуля требует гораздо больше, поэтому большинство команд вместо этого дорабатывают предварительно обученную модель. Качество и согласованность меток важнее, чем их объем; зашумленные данные быстро ограничивают точность.
Следует ли мне создавать обучающий набор данных для распознавания именованных сущностей самостоятельно или заказать аннотирование у стороннего специалиста?
Аутсорсинг необходим, когда требуется большой объем работы, скорость, экспертные знания в предметной области или соответствие требованиям, которые невозможно обеспечить собственными силами; разработку собственными силами следует проводить только в том случае, если ваша схема проста, стабильна и невелика. Большинство команд недооценивают аннотирование — рекомендации, разметка и контроль качества занимают основную часть проекта по распознаванию именованных сущностей. Специализированный партнер, такой как Shaip, берет на себя эту нагрузку, позволяя вашим инженерам сосредоточиться на моделировании, а не на разметке.
Почему моя модель распознавания именованных сущностей постоянно пропускает сущности, специфичные для предметной области?
Поскольку универсальные модели обучаются на новостных и веб-текстах, они редко распознают специализированные термины, такие как названия лекарств, юридические положения или финансовые инструменты. Решение заключается в тонкой настройке на аннотированных данных, содержащих эти сущности в реалистичном контексте. Другой распространенной причиной являются непоследовательные правила разметки, поэтому необходимо тщательно проработать правила аннотирования перед масштабированием.
Сколько стоит создание собственного набора данных для распознавания именованных сущностей?
Стоимость зависит от сложности сущности, объема аннотаций, необходимой экспертной оценки в предметной области и требований к соответствию стандартам — маркировка клинического или юридического текста обходится дороже, чем маркировка обычного текста, поскольку требует привлечения экспертов-аннотаторов и более строгого контроля качества. Цены обычно указываются за страницу, за документ или за аннотированную единицу. Компания Shaip определяет объем каждого проекта по распознаванию именованных сущностей в соответствии с вашей схемой и стандартами качества и предоставляет индивидуальное коммерческое предложение.
Где можно найти высококачественные обучающие данные для распознавания именованных сущностей (NER) или для клинической практики?
Получить обучающие данные для распознавания именованных сущностей можно тремя способами: лицензировать готовый набор данных, собрать и аннотировать собственный набор данных или расширить существующий корпус. Для работы в специализированной или регулируемой области — медицине, юриспруденции, финансах — надежным вариантом является управляемый поставщик услуг аннотирования. Shaip предоставляет пользовательские наборы данных для распознавания именованных сущностей, клинические данные для распознавания именованных сущностей и данные для деидентификации, соответствующие требованиям HIPAA, разработанные в точном соответствии с вашими спецификациями.
В чём разница между NER (распознаванием именованных сущностей), извлечением сущностей и связыванием сущностей?
NER (распознавание именованных сущностей) обнаруживает и классифицирует сущности по типу (человек, организация, местоположение). Термины «извлечение сущностей» часто используются как синоним NER, иногда в более широком смысле для извлечения структурированных полей из текста. Связывание сущностей идет еще дальше, соединяя распознанную сущность с уникальной записью в базе знаний — определяя, о каком именно «Apple» идет речь, а о каком «Jordan».
Заключение
Распознавание именованных сущностей (NER) — это мощный метод обработки естественного языка, который идентифицирует и классифицирует ключевые сущности в тексте, позволяя машинам понимать и обрабатывать человеческий язык более эффективно. От улучшения поисковых систем и чат-ботов до поддержки клиентов и финансового анализа, NER имеет разнообразные приложения в различных отраслях. Хотя в таких областях, как разрешение неоднозначности и обработка неструктурированных данных, остаются проблемы, текущие достижения, особенно в области глубокого обучения, обещают дальнейшее совершенствование возможностей NER и расширение его влияния в будущем.




