Создавайте постоянно работающие голосовые приложения с использованием специально подобранных данных для обучения распознавания ключевых слов. Более высокая точность обнаружения, меньше ложных срабатываний.
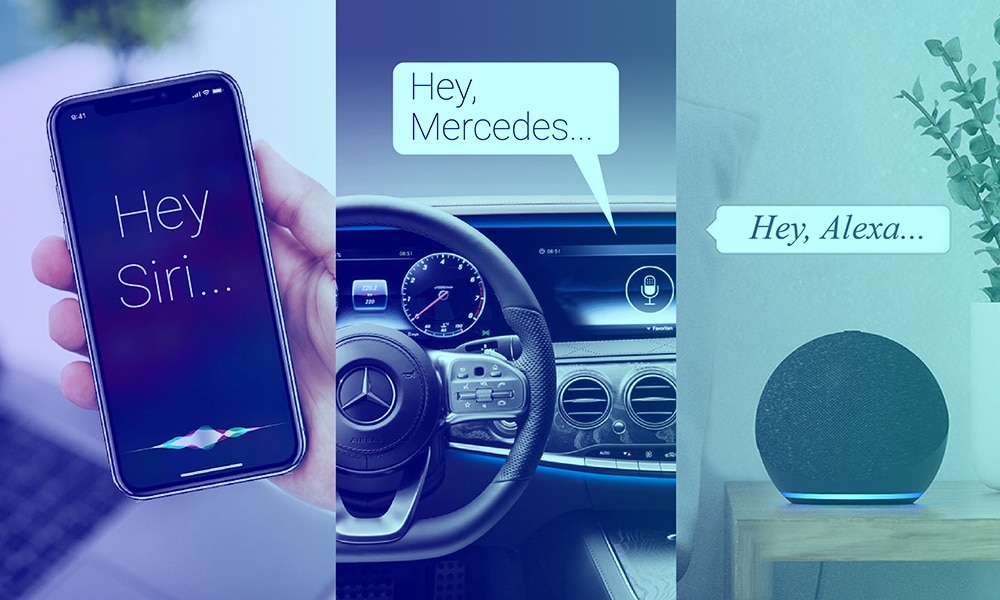
Голосовые помощники кардинально изменили способ взаимодействия клиентов со своими устройствами. Они упростили пользователям изучение продуктов и услуг — быстро и эффективно. Однако слушает ли голосовое приложение? Чтобы поставить эти приложения на высокий уровень, их нужно разбудить и перевести с пассивного на активное прослушивание с помощью WAKE WORDS. «Алекса» и «Привет, Сири» — два самых популярных слова для пробуждения в мире.
По прогнозам, к 2024 году количество цифровых голосовых помощников достигнет 8.4 миллиарда единиц — это больше, чем население мира.
По прогнозам, объем рынка приложений голосовых помощников вырастет с 2.8 млрд долларов в 2021 году до 11.2 млрд долларов в 2026 году, при среднегодовом темпе роста в 32.4%.
Ключевое слово — это конкретное слово или фраза, например, «Привет, Siri», «Окей, Google» и «Алекса», предназначенные для активации голосового устройства, которое реагирует на произнесение. Однако постоянно активируемое ключевое слово, локально интегрированное в устройство, значительно сокращает время реакции и повышает точность распознавания и обработки ключевого слова даже без подключения к интернету. Shaip собирает данные для обучения распознавания ключевых слов на более чем 100 языках, с различными акцентами, возрастными группами и в условиях реального шума, чтобы максимизировать точность обнаружения и минимизировать ложные срабатывания. Они также известны как:
Благодаря программе Shaip, которая предлагает постоянное прослушивание слова пробуждения, ваши модели голосового помощника всегда настроены на прослушивание слова пробуждения, но без фактической записи или передачи данных в облако. Партнерство с Shaip дает вам преимущество работы с экспертами. Благодаря нашему обширному опыту использования технологий искусственного интеллекта и машинного обучения при разработке обучения голосовому помощнику, мы помогаем вам устранить риски, связанные с конфиденциальностью, улучшить взаимодействие с пользователем, снизить затраты на разработку и повысить масштабируемость.
Shaip создает обучающие данные для полностью брендированных ключевых слов активации, чтобы клиенты произносили название вашего бренда, а не имя универсального голосового помощника. Каждый набор данных настроен на вашу точную фразу активации, что повышает запоминаемость бренда при каждом взаимодействии и сохраняет голосовой интерфейс в рамках вашей собственной экосистемы.
Shaip поддерживает модели распознавания ключевых слов, работающие на устройстве без записи или передачи звука в облако. Данные для обучения распознавания ключевых слов на устройстве уменьшают задержку, снижают риски для конфиденциальности и обеспечивают надежную работу системы распознавания даже без подключения к интернету.
Shaip собирает кодовые слова для активации речи на более чем 100 языках и с различными региональными акцентами — шотландском, канадском, австралийском, индийском английском и других — поэтому точность распознавания сохраняется для пользователей по всему миру, а не снижается для тех, кто не является носителем языка.
Shaip собирает данные о ключевых словах в условиях тишины, шума, в автомобиле, на открытом воздухе и на большом расстоянии. Обучение на реальных акустических условиях снижает количество ложных срабатываний, когда пользователи говорят на расстоянии или в условиях фонового шума.
Помимо ключевого слова, Shaip предоставляет данные о речевых оборотах и фразах, благодаря чему устройства обрабатывают более длинные команды на естественном языке с низкой задержкой. Встроенные данные об распознавании ключевых слов поддерживают обработку в браузере и на чипе для обеспечения высокой точности и конфиденциальности.
Различные фонемы обычно создают более отчетливую подпись и обеспечивают лучшую точность результатов. Следовательно, выберите фразы в ваших данных, которые производят различные звуки.
Сделайте слова пробуждения более эффективными, добавив к ним такие префиксы, как «Привет», «Привет», «Привет» или «ОК». Это сохранит однозначность слова пробуждения и гарантирует отсутствие случайного совпадения при использовании триггерного слова в обычной речи.
Сделайте слова для пробуждения комбинацией не менее шести фонем, которые легко различимы машиной и легко произносимы людьми. Например, «Alexa» имеет шесть феноменов, а «Ok Google» — восемь феноменов.
Не делайте ошибку, используя одно слово в качестве слова для пробуждения. Слова пробуждения должны быть достаточно длинными, чтобы их можно было различить.
Убедитесь, что триггерные слова, которые вы создаете, должны быть простыми и уникальными, чтобы их можно было легко запомнить.
Длинные пробуждающие фразы, состоящие из нескольких слов, трудно произносить и излишне усложняют процесс.
Модель слова пробуждения обычно обучена распознавать нет. разных высказываний, чтобы он мог реагировать на разные вызовы. Однако наличие слишком большого количества различных пробуждающих слов может просто активировать речевой конвейер, и вы не будете знать, какое высказывание произнес пользователь.
Такие факторы, как шум, расстояние и различия в акцентах и языке, усложняют точное обнаружение ключевых слов для вашей модели искусственного интеллекта.
Наш опыт в области голосовых технологий помогает нам быстро разрабатывать слова для пробуждения, которые всегда можно услышать, и фирменные фразы для пробуждения. Благодаря распознаванию голоса в сочетании с пониманием обработки естественного языка алгоритмы машинного обучения помогают эффективно расшифровывать речь и выполнять голосовые команды.
Мы сосредоточены на быстро развивающемся прототипировании слова пробуждения, чтобы обеспечить настройку фирменного слова. Прототип действует как доказательство концепции и помогает в точном обучении, ускорении выхода на рынок, ускоренном тестировании и устранении рисков.
Испытайте непрерывный рост и беспрепятственное взаимодействие с клиентами с исключительным голосовым помощником. Мы предоставляем возможности многоязычного распознавания речи, чтобы приложение могло точно распознавать слова и фразы даже в условиях сильного шума.
Это способ сбора важных данных о пользователях, таких как их личность, страна происхождения, возраст, пол, язык, акцент и т. д. Разнообразие данных используется для улучшения алгоритмов, ориентированных на пользователя, для достижения более точных результатов.
Обычно данные имеют тенденцию генерировать встроенные предубеждения. Поэтому, когда мы собираем данные из разных источников, систематическая ошибка в результатах значительно снижается.
Вот несколько параметров разнообразия данных, на которые Shaip обращает внимание при построении слов пробуждения и других диалоговых команд.
| Раса и этническая принадлежность | Индуисты, мусульмане, христиане, африкаанс, европейцы |
| Уровень образования | Бакалавриат, аспирант, доктор философии, магистры |
| Страна | Китай, Япония, Индия, Корея, Дубай, Нигерия, США, Канада |
| Секс | Мужчина, Женщина |
| Возраст | Менее 10 лет, 10-15, 15-25, 25-45, 45 лет и старше |
| Язык | английский, японский, турецкий, китайский, тайский, хинди |
| Окружающая среда | Тишина, Шум, Фоновая музыка, Фоновый звук/речь, В помещении, На открытом воздухе, Театр, Стадион, Кафетерий, В машине, Офис, Торговый центр, Домашний шум, Лестница, Улица/Дорога, На побережье (ветрено) |
| Акценты (английский) | Шотландский английский, валлийский английский, ирландский английский, канадский английский, австралийский английский, новозеландский английский |
| Стиль речи | Быстрая/Нормальная/Медленная скорость, Высокая/Нормальная/Спокойная громкость, Формальный/Повседневный |
| Позиции устройств | Портативный, настольный |
Кодовое слово для активации колонок, телевизоров и других устройств, которые должны мгновенно включаться и блокировать фоновые разговоры.
Наборы данных ключевых слов для активации в условиях дальнего поля, устойчивые к шуму, для систем голосового управления в салоне автомобиля.
Данные для активации с минимальным потреблением энергии для постоянно включенных устройств с ограниченным зарядом батареи.
Настраиваемые данные о ключевом слове и фразах для локализации голосовых помощников на разных языках и диалектах.
Приоритет — конфиденциальность, данные о ключевом слове, передаваемые непосредственно на устройство, для использования в клинических и лечебных условиях без помощи рук.
Мультимодальные данные о ключевых словах и командах активации для роботов, реагирующих в режиме реального времени без использования облачных технологий.
Компания Shaip поможет вам выбрать фонетически отличное, соответствующее бренду кодовое слово для активации и определить правила оформления коллекции.
Сотрудники компании Shaip по всему миру записывают кодовое слово для активации устройства, учитывая необходимые языки, акценты, возраст, устройства и уровень шума.
Каждое высказывание расшифровывается, помечается и проверяется на соответствие вашим критериям приемлемости.
Shaip предоставляет структурированные, управляемые политиками обучающие данные для распознавания ключевых слов, отформатированные для вашего конвейера моделирования.
Для эффективного развертывания вашей инициативы AI вам потребуются большие объемы специализированных наборов данных для обучения. Shaip - одна из немногих компаний на рынке, которая обеспечивает надежные данные обучения мирового класса в масштабе, соответствующем нормативным требованиям и требованиям GDPR.
Создавайте, курируйте и собирайте настраиваемые наборы данных (текст, речь, изображения, видео) из более чем 100 стран по всему миру на основе настраиваемых правил.
Используйте нашу глобальную команду из 30,000+ опытных и сертифицированных участников. Гибкое распределение задач и мониторинг потенциала, эффективности и прогресса персонала в реальном времени.
Наша запатентованная платформа и квалифицированный персонал используют несколько методов контроля качества, чтобы соответствовать или превосходить стандарты качества, установленные для сбора наборов данных для обучения ИИ.
Наш процесс упрощает процесс сбора за счет более простого распределения задач, управления и сбора данных непосредственно из приложения и веб-интерфейса.
Сохраняйте полную конфиденциальность данных, делая конфиденциальность нашим приоритетом. Мы гарантируем, что форматы данных контролируются и сохраняются в соответствии с политикой.
Кураторские данные по предметной области, собранные из отраслевых источников на основе рекомендаций по сбору данных о клиентах.
Shaip предлагает комплексные услуги по сбору речевых/аудиоданных на более чем 150 языках, чтобы технологии с поддержкой голоса могли обслуживать разнообразную аудиторию по всему миру.
Чат-бот, с которым вы разговаривали, работает на продвинутой системе диалогового ИИ, которая обучена, протестирована и построена с использованием множества наборов данных для распознавания речи. Это фундаментальный процесс, лежащий в основе технологии, которая делает машины интеллектуальными.
Потребность в обучении произношению возникает, потому что не все клиенты используют точные слова или фразы, взаимодействуя или задавая вопросы своим голосовым помощникам в формате сценария.
Расширение возможностей команд для создания ведущих в мире продуктов искусственного интеллекта.
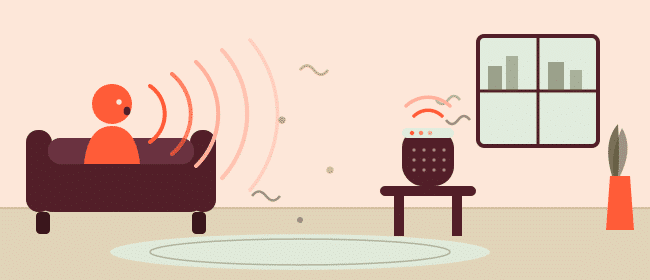
Ключевое слово активации — это определенное слово или фраза, например, «Алекса», «Окей, Google» или специально разработанная фраза, которая активирует устройство с поддержкой голосового управления и переключает его из пассивного режима в активный. Устройство постоянно прослушивает локально состояние на предмет ключевого слова активации и начинает обрабатывать запрос только после его обнаружения.
Данные для обучения с использованием ключевых слов — это размеченный набор речевых записей, используемый для обучения модели распознаванию фразы активации. Эффективные данные для обучения с использованием ключевых слов охватывают множество говорящих, акцентов, возрастов, устройств и условий шума, поэтому модель срабатывает надежно, отсеивая при этом похожие по звучанию речи.
Функция активации по ключевому слову работает за счет запуска небольшой, постоянно работающей модели распознавания, которая сканирует входящий аудиопоток на наличие целевой фразы. Когда модель с достаточной степенью достоверности сопоставляет ключевое слово, устройство активируется и начинает обработку запроса пользователя с помощью распознавания речи и обработки естественного языка.
Надежное пользовательское кодовое слово для активации использует разнообразные фонемы, содержит не менее трех-четырех слогов и избегает распространенных повседневных слов, чтобы уменьшить количество ложных срабатываний. Добавление префикса, например, «Привет» или «ОК», повышает различимость. Shaip помогает выбирать и проверять кодовые слова во время настройки проекта.
Да. Функция распознавания ключевого слова на устройстве запускает модель активации локально, поэтому аудио не записывается и не отправляется в облако. Это снижает задержку, защищает конфиденциальность и позволяет использовать функцию распознавания в автономном режиме. Shaip собирает обучающие данные, специально адаптированные для развертывания на устройстве и встроенных системах.
Компания Shaip собирает данные для обучения распознавания ключевых слов на более чем 100 языках и с широким спектром региональных акцентов, полученные от сотрудников со всего мира, работающих в более чем 100 странах. Такое разнообразие позволяет сократить разрыв в точности распознавания для носителей других языков и способствует глобальному запуску продуктов.
Shaip применяет многоступенчатый контроль качества — проверку транскрипции, критерии приемки и мониторинг персонала — чтобы наборы данных соответствовали целевой точности до момента доставки. Разнообразные высококачественные данные снижают как количество ложных срабатываний, так и количество ложных отклонений в используемой модели.
Ключевое слово активирует устройство; произнесенная фраза — это следующий за ним голосовой запрос. Распознавание ключевого слова — это задача, требующая постоянной активации, в то время как понимание фразы включает в себя интерпретацию разнообразных фраз на естественном языке. Shaip предоставляет обучающие данные как для распознавания ключевого слова, так и для сбора фраз.
Высказывание — это фраза, которую пользователь произносит, чтобы обратиться к программе голосового управления. Программа определяет намерение пользователя по высказыванию и отвечает соответствующим образом. В отличие от полного предложения, высказывание — это единица речи, которая может не передавать полную мысль и часто содержит паузы. Примеры: «Покажите мне последний фильм — тот, что вышел на прошлой неделе» или «Магазин на 22-й улице сейчас открыт?»
Имя вызова — это ключевое слово, используемое для запуска определенного «навыка» в голосовом программном обеспечении. Оно может включать имена людей или мест и сочетаться с действием, командой или вопросом. Каждому пользовательскому навыку необходимо имя вызова для его запуска.
Слова-активаторы также называют словами-триггерами, ключевыми словами, словами активации, словами-призывами, фразами-активаторами и высказываниями.
Alexa использует несколько встроенных микрофонов для распознавания ключевого слова активации, одновременно отфильтровывая фоновый шум. Чтобы предотвратить ложные срабатывания и ошибки, она начинает активное прослушивание только после распознавания слова «Alexa».
Мы используем файлы cookie для улучшения вашего опыта на нашем сайте. Используя наш сайт, вы соглашаетесь на файлы cookie.
Управляйте настройками файлов cookie ниже:
Основные файлы cookie включают основные функции и необходимы для правильной работы сайта.
Диспетчер тегов Google упрощает управление маркетинговыми тегами на вашем сайте без изменения кода.
Статистические файлы cookie собирают информацию анонимно. Эта информация помогает нам понять, как посетители используют наш веб-сайт.
Google Analytics — мощный инструмент, который отслеживает и анализирует трафик веб-сайта для принятия обоснованных маркетинговых решений.
URL сервиса: policies.google.com (откроется в новом окне)
Маркетинговые файлы cookie используются для отслеживания посетителей веб-сайтов. Цель состоит в том, чтобы показывать рекламу, которая актуальна и интересна для отдельного пользователя.
Google Ads — это онлайн-платформа для размещения рекламы, которая позволяет компаниям создавать целевые объявления, отображаемые в результатах поиска Google и на сайтах партнеров.
URL сервиса: policies.google.com (откроется в новом окне)
HubSpot — это универсальная платформа для маркетинга, продаж и обслуживания клиентов, которая способствует росту бизнеса.
URL сервиса: legal.hubspot.com (откроется в новом окне)
Более подробную информацию вы найдете в нашей Политике использования файлов cookie и Политике конфиденциальности.