Почему нейтральность данных как никогда важна в обучающих данных для ИИ
Если искусственный интеллект — это двигатель вашего бизнеса, то обучающие данные — это топливо.
Но вот неприятная правда: то, кто контролирует это топливо и как он его использует, теперь имеет такое же значение, как и качество самих данных. В этом и заключается суть идеи нейтральности данных .
За последние пару лет крупные технологические компании, партнерства в рамках моделей фондов и новые правила превратили нейтральность данных из нишевой концепции в важнейший вопрос бизнеса и соблюдения нормативных требований. Нейтральные, высококачественные обучающие данные больше не являются «желательным дополнением» — они имеют решающее значение для защиты вашей интеллектуальной собственности, предотвращения предвзятости и обеспечения лояльности регулирующих органов (и клиентов).
В этой статье мы разберем, что означает нейтральность данных на практике, почему она важна как никогда и как оценить, действительно ли ваш партнер по предоставлению данных для обучения ИИ является нейтральным.
Что на самом деле подразумевается под «нейтральностью данных» в контексте искусственного интеллекта?
Давайте обойдемся без юридических тонкостей и поговорим простым языком.
В искусственном интеллекте нейтральность данных — это идея, согласно которой ваши обучающие данные являются:
Собрано и обработано независимо. в интересах ваших конкурентов
Использовать только в тех целях, на которые вы согласитесь. (никакого «тайного повторного использования» для разных клиентов)
Регулируется прозрачными правилами. о предвзятости, доступе и собственности
Защищен от конфликтов интересов в том, как он получен, аннотирован и хранится.
Представьте себе обучающие данные для вашего ИИ как водопроводную сеть города.
Если одна частная компания владеет всеми трубопроводами и одновременно ведет конкурирующий водоемкий бизнес, вы будете обеспокоены тем, насколько чистым, справедливым и надежным является это водоснабжение. Нейтралитет заключается в том, чтобы гарантировать, что ваш ИИ не станет зависимым от источника данных, контролируемого кем-то, чьи интересы не полностью совпадают с вашими.
В отношении обучающих данных для ИИ нейтральность применима ко всем:
Справедливость и предвзятость – Систематически ли недостаточно представлены некоторые группы или точки зрения?
Независимость – Ваш поставщик также разрабатывает собственные конкурентные модели?
Суверенитет данных – Кто в конечном итоге контролирует, где хранятся ваши данные и как их можно использовать повторно?
Защита IP – Могут ли ваши с трудом полученные знания проникнуть в чужую модель?
Нейтральность данных — это дисциплина, позволяющая ответить «да, мы защищены» на все эти вопросы и доказать это.
Почему принцип нейтральности данных стал реальностью
Несколько лет назад «нейтральные обучающие данные» звучали как некая философская прихоть, которую лучше иметь. Сегодня это тема для обсуждения в залах заседаний совета директоров.
Консолидация рынка и зависимость от поставщика
Последние шаги – такие как углубление связей крупных технологических компаний с поставщиками данных и приобретение крупных долей в платформах для обучения моделей данных – изменили профиль рисков для любой компании, которая передает сбор и аннотирование данных на аутсорсинг.
Если ваш основной поставщик обучающих данных теперь частично принадлежит крупной технологической компании, которая:
Конкурирует с вами напрямую, или
Является ли создание моделей вашей областью деятельности?
Тогда вам придётся задавать сложные вопросы:
Будут ли мои данные, даже в совокупности, использованы для улучшения моделей моих конкурентов?
Получу ли я тот же приоритет и качество, если мой план действий будет противоречить их плану?
Насколько легко уехать, если что-то изменится?
Регулирование и ожидания потребителей
Регуляторы наверстывают упущенное. Статья 10 Закона ЕС об ИИ прямо требует наличия высококачественных наборов данных, которые являются релевантными, репрезентативными и надлежащим образом управляемыми для систем ИИ, представляющих высокий риск.
В то же время опросы показывают, что подавляющее большинство американских потребителей хотят прозрачности в том, как бренды получают данные для моделей искусственного интеллекта , и с большей вероятностью доверяют организациям, которые могут это четко объяснить.
Иными словами, планка повышается. Фраза «Мы купили данные и запустили их в модель» больше не устраивает регулирующие органы, клиентов и вашу собственную команду по управлению рисками.
Короткая (гипотетическая) история
Представьте, что вы — руководитель отдела по работе с клиентами в быстрорастущей SaaS-компании. Вы передаете сбор и аннотирование обучающих данных для вашего помощника по поддержке клиентов известному поставщику.
Шесть месяцев спустя этого поставщика приобрела крупная технологическая компания, запустившая конкурирующий продукт для улучшения пользовательского опыта. Некоторые члены вашего совета директоров спрашивают, могут ли ваши обучающие данные — особенно данные о крайних случаях и конфиденциальной обратной связи — повлиять на их модель.
Ваши юридические и комплаенс-отделы начинают углубляться в контракты, соглашения об обработке персональных данных и внутренние процессы. Внезапно ИИ перестает быть просто историей инноваций; он становится историей управления и доверия.
Вот что происходит, когда нейтральность данных не являлась критерием отбора с самого начала.
Как нейтральность данных влияет на качество обучающих данных для ИИ
Нейтральность — это не только политика и вопросы собственности, она тесно связана с качеством данных и эффективностью ваших моделей.
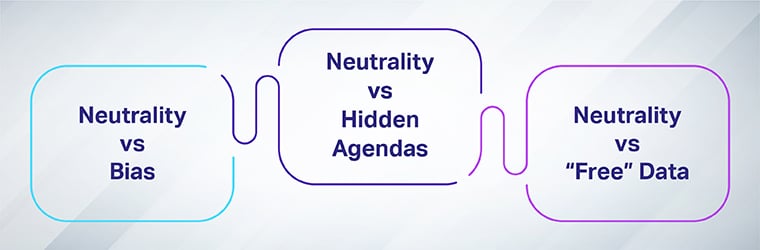
Нейтралитет против предвзятости: разнообразие, заложенное в проекте.
Нейтральные партнеры с большей вероятностью будут отдавать приоритет разнообразным, репрезентативным данным об обучении , поскольку их бизнес-модель основана на том, чтобы быть надежным и беспристрастным поставщиком, а не на продвижении какой-либо конкретной повестки дня.
Нейтралитет против скрытых мотивов: кому принадлежит трубопровод?
Если ваш поставщик данных также разрабатывает конкурирующие продукты, всегда существует риск – пусть даже и кажущийся – что:
Ваши самые сложные задачи становятся «золотым кладезем для обучения» конкурирующей модели.
Ваши экспертные знания в данной области определяют их планы развития.
При распределении ресурсов предпочтение отдается внутренним проектам, а не срокам их выполнения.
У действительно нейтрального поставщика обучающих данных для ИИ одна задача: помочь вам создавать лучшие модели, а не себе.
Нейтральность против «свободных» данных: открытый исходный код ≠ нейтральность
Открытые или собранные с помощью парсинга наборы данных могут показаться заманчивыми: быстро, дешево, в изобилии. Но зачастую они сопряжены со следующими недостатками:
Вопросы лицензирования и правовая неопределенность
Асимметричное распределение, укрепляющее существующие властные структуры
Документация о методах сбора данных ограничена.
В настоящее время многие аналитические исследования указывают на скрытые опасности данных из открытых источников – от юридической ответственности до системной предвзятости.
В данном контексте нейтральность означает честное определение того, когда «бесплатные» данные имеют смысл, а когда вместо них необходимы тщательно отобранные, полученные этичным способом и высококачественные обучающие данные для ИИ.
Ключевые принципы нейтральности данных в обучающих данных для ИИ
Так на что же следует обратить внимание?
Независимость и позиционирование без конкуренции
Нейтральный поставщик:
Не создавайте основные продукты, которые напрямую конкурируют с вашим ИИ.
Имеет четкие внутренние правила для защиты данных клиентов.
Обеспечивает прозрачность в отношении инвесторов, партнерских отношений и стратегических интересов.
Это похоже на выбор независимого аудитора – вам нужен тот, чьи интересы совпадают с интересами доверия и точности, а не с интересами роста ваших конкурентов.
Этичные, соответствующие нормативным требованиям и ориентированные на защиту конфиденциальности закупки.
В условиях действия таких нормативных актов, как Закон ЕС об искусственном интеллекте, GDPR и отраслевых правил, нейтральность данных должна основываться на надежной защите и управлении данными.
Документированное согласие и методы сбора данных
При необходимости обеспечивается строгая деидентификация.
Четкие правила хранения и удаления данных
Отслеживаемые журналы движения данных по всей цепочке обработки.
Здесь этичное использование обучающих данных для ИИ тесно пересекается с принципами нейтральности: вы не можете заявлять о нейтральности, если ваши источники информации непрозрачны или носят эксплуатационный характер.
Качество, разнообразие и управление по замыслу
Высококачественные обучающие данные не только точны, но и управляемы :
Планы выборки, обеспечивающие репрезентативность по языкам, демографическим характеристикам и контекстам.
Многоуровневый контроль качества (рецензенты, эксперты, эталонные наборы данных)
Непрерывный мониторинг на предмет дрейфа, закономерностей ошибок и новых граничных случаев.
Независимые поставщики услуг вкладывают значительные средства в эти процессы, поскольку доверие — это их продукт.
Практический контрольный список для выбора нейтрального партнера по предоставлению обучающих данных для ИИ.
Вот контрольный список для поставщиков, который вы можете буквально вставить в свой запрос предложений.
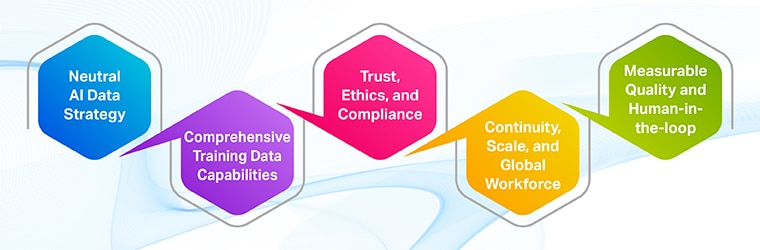
1. Стратегия использования нейтральных данных в ИИ.
Спросите:
Вы производите или планируете производить продукцию, которая будет конкурировать с нашей?
Как вы гарантируете, что наши данные не будут использованы повторно — даже в анонимизированной форме — способами, на которые мы не давали согласия?
Что произойдет с нашими данными, если изменится ваша форма собственности или партнерские отношения?
2. Комплексные возможности по работе с обучающими данными для ИИ.
Нейтральный поставщик услуг должен по-прежнему обладать сильными сторонами в плане исполнения:
Сбор, аннотирование и проверка данных в различных областях. текст, изображение, аудио и видео
Опыт работы в вашей сфере (например, здравоохранение, автомобильная промышленность, финансы) Возможность поддерживать как классическое машинное обучение, так и генеративный искусственный интеллект.
3. Доверие, этика и соблюдение правил.
Ваш поставщик должен быть в состоянии продемонстрировать:
Соответствие соответствующим нормативным актам (например, GDPR; соответствие принципам Закона ЕС об искусственном интеллекте).
Четкие подходы к получению согласия, обезличиванию данных и безопасному хранению информации.
Внутренние аудиты и внешняя сертификация, где это применимо.
Прозрачные процессы обработки сообщений об инцидентах и запросов субъектов данных.
Чтобы углубиться в этот вопрос, можно связать нейтральность с более широкими дискуссиями об этичном использовании данных в ИИ — например, с теми, которые рассматриваются в статье Шаипа о построении доверия к машинному обучению с помощью этичных данных.
4. Непрерывность, масштаб и глобальный кадровый состав.
Нейтралитет без оперативной мощи недостаточен. Обратите внимание на:
Продемонстрированная способность управлять крупными, многонациональными проектами в масштабах, охватывающих несколько стран.
Глобальная сеть участников и надежная система полевых операций.
Эффективное управление проектами, соблюдение соглашений об уровне обслуживания (SLA) и поддержка в процессе перехода/адаптации.
5. Измеримое качество и участие человека в процессе.
Наконец, убедитесь, что нейтральность подкреплена измеримыми показателями :
Многоуровневая проверка качества и экспертная оценка
Золотые наборы данных и тестовые наборы
Рабочие процессы с участием человека для сложных или конфиденциальных задач.
Нейтральные партнеры спокойно представляют качественные показатели на бумаге, поскольку их бизнес зависит от предоставления стабильных и заслуживающих доверия результатов.
Как компания Shaip подходит к обеспечению нейтральности данных в обучающих данных
В компании Shaip нейтральность тесно связана с тем, как мы получаем, обрабатываем и регулируем обучающие данные :
Независимая ориентация на данным: Мы специализируемся на данных для обучения ИИ — сборе, аннотировании, проверке и обработке данных — а не на конкуренции с клиентами на их конечных рынках.
Этический, приоритет конфиденциальности при выборе поставщиков: В наших рабочих процессах особое внимание уделяется согласию, обезличиванию данных там, где это необходимо, и обеспечению безопасной среды для конфиденциальных данных в соответствии с современными нормативными требованиями.
Качество и разнообразие заложены в самом дизайне: От открытых наборов данных до пользовательских коллекций — мы уделяем приоритетное внимание всем аспектам. высококачественные, репрезентативные обучающие данные для ИИ в разных языках, демографических группах и форматах.
Участие человека и управление: Мы объединяем глобальный опыт специалистов с механизмами контроля качества на уровне платформы, управлением участниками проекта и проверяемыми рабочими процессами.
Если вы пересматриваете свою стратегию работы с данными, нейтральность — это мощный инструмент: полностью ли наши партнеры по работе с данными разделяют наши цели — и только наши цели?
Что такое нейтральность данных в искусственном интеллекте?
Нейтральность данных — это практика сбора, управления и использования обучающих данных независимым, справедливым и свободным от конфликта интересов способом . Она гарантирует, что ваш поставщик данных не будет повторно использовать ваши данные способами, на которые вы не соглашались, не будет напрямую конкурировать с вами, используя ваши собственные выводы, и будет следовать прозрачному и этичному управлению.
Почему нейтральность данных важна для обучающих данных ИИ?
Потому что обучающие данные определяют поведение ваших моделей. Без нейтральности вы рискуете:
Скрытая предвзятость, заложенная в наборы данных.
Утечка интеллектуальной собственности конкурентам
Проблемы соблюдения требований законодательства в сфере искусственного интеллекта.
Потеря доверия клиентов, если методы получения данных вызывают сомнения.
Какова взаимосвязь между нейтральностью данных и суверенитетом данных?
Суверенитет данных — это вопрос о том, кто в конечном итоге контролирует и управляет вашими данными (часто это связано с географией и регулированием). Нейтральность данных — это вопрос о том, осуществляется ли этот контроль справедливо и независимо. Вам нужны оба варианта: суверенный контроль над местом хранения ваших данных и нейтральные партнеры, у которых нет противоречащих интересов. Network World+1
Как узнать, действительно ли поставщик обучающих данных для ИИ является нейтральным?
Спросить:
Чётко укажите, производят ли они продукцию, конкурирующую с вашей.
Договорные обязательства по повторному использованию данных и обучению моделей.
Прозрачность в отношении инвесторов и стратегических партнерств.
Доказательства этичного и соответствующего нормативным требованиям подхода к сбору и управлению данными (аудиты, сертификаты, тематические исследования).
Если ответы расплывчаты, то нейтралитет может оказаться скорее маркетинговым ходом, чем реальностью.
Является ли использование открытых обучающих данных нейтральным по отношению к другим источникам?
Не обязательно. Открытые наборы данных могут быть ценными, но они часто:
Отражать предвзятость тех, кто их создавал и отбирал.
Отсутствие подробной документации по методам сбора данных.
Имеются пробелы в лицензировании или согласии.
Открытые наборы данных следует рассматривать как один из элементов более широкой, управляемой стратегии работы с данными, а не как автоматически нейтральные или безрисковые.
Понравилась статья? Подпишитесь на Шаипа в LinkedIn, чтобы получать больше новостей.
Содержит информацию, связанную с маркетинговыми кампаниями пользователя. Они передаются в Google AdWords / Google Ads, когда аккаунты Google Ads и Google Analytics связаны друг с другом.
90 дней
__utma
Идентификатор, используемый для идентификации пользователей и сеансов
2 года после последней активности
__utmt
Используется для мониторинга количества запросов к серверу Google Analytics.
10 минут
__utmb
Используется для различения новых сеансов и посещений. Этот файл cookie устанавливается при загрузке библиотеки GA.js javascript и отсутствии существующего файла cookie __utmb. Файл cookie обновляется каждый раз, когда данные отправляются на сервер Google Analytics.
30 минут после последней активности
__utmc
Используется только со старыми версиями Urchin Google Analytics, но не с GA.js. Используется для различения новых сеансов и посещений в конце сеанса.
Конец сеанса (браузер)
__utmz
Содержит информацию об источнике трафика или кампании, которая направила пользователя на сайт. Файл cookie устанавливается при загрузке GA.js javascript и обновляется при отправке данных на сервер Google Anaytics
6 месяцев после последней активности
__utmv
Содержит пользовательскую информацию, установленную веб-разработчиком через метод _setCustomVar в Google Analytics. Этот файл cookie обновляется каждый раз, когда новые данные отправляются на сервер Google Analytics.
2 года после последней активности
__utmx
Используется для определения того, включен ли пользователь в A/B-тест или многомерный тест.
18 месяцев.
_ga
ID, используемый для идентификации пользователей
2 лет
_gali
Используется Google Analytics для определения того, какие ссылки на странице нажимаются
(30%)
_га_
ID, используемый для идентификации пользователей
2 лет
_gid
Идентификатор, используемый для идентификации пользователей в течение 24 часов после последней активности
24 часа
_gat
Используется для мониторинга количества запросов к серверу Google Analytics при использовании Google Tag Manager.
1 минут
Маркетинговые файлы cookie используются для отслеживания посетителей веб-сайтов. Цель состоит в том, чтобы показывать рекламу, которая актуальна и интересна для отдельного пользователя.
Google Ads — это онлайн-платформа для размещения рекламы, которая позволяет компаниям создавать целевые объявления, отображаемые в результатах поиска Google и на сайтах партнеров.
Файл cookie таргетинга. Используется для создания профиля пользователя и показа пользователю релевантной и персонализированной рекламы Google.
2 лет
__Secure-1PSID
Файл cookie таргетинга. Используется для создания профиля пользователя и показа пользователю релевантной и персонализированной рекламы Google.
2 лет
__Secure-3PAPISID
Составляет профили интересов посетителей веб-сайта для показа релевантной и персонализированной рекламы посредством ретаргетинга.
2 лет
АЭК
Файлы cookie AEC гарантируют, что запросы в сеансе просмотра выполняются пользователем, а не другими сайтами. Эти файлы cookie не позволяют вредоносным сайтам действовать от имени пользователя без его ведома.
6 месяцев.
ADS_VISITOR_ID
Для использования опций и веб-сервисов на сайте требуются файлы cookie
2 месяцев.
__Secure-3PSIDCC
Файл cookie таргетинга. Используется для создания профиля пользователя и показа пользователю релевантной и персонализированной рекламы Google.
2 лет
__Secure-3PSIDTS
Файл cookie таргетинга. Используется для создания профиля пользователя и показа пользователю релевантной и персонализированной рекламы Google.
2 лет
__Secure-1PSIDTS
Файл cookie таргетинга. Используется для создания профиля пользователя и показа пользователю релевантной и персонализированной рекламы Google.
2 лет
__Secure-1PAPISID
Файл cookie таргетинга. Используется для создания профиля пользователя и показа пользователю релевантной и персонализированной рекламы Google.
2 лет
__Secure-3PSID
Файл cookie таргетинга. Используется для профилирования интересов посетителей веб-сайта и показа релевантной и персонализированной рекламы Google.
2 лет
Конверсия
Google использует файлы cookie для рекламы, включая показ и отображение рекламы, персонализацию рекламы (в зависимости от настроек рекламы на g.co/adsettings), ограничение количества показов рекламы пользователю, отключение рекламы, которую вы решили не показывать, и оценку эффективности рекламы.
90 дней
_gcl_aw
Google использует файлы cookie для рекламы, включая показ и отображение рекламы, персонализацию рекламы (в зависимости от настроек рекламы на g.co/adsettings), ограничение количества показов рекламы пользователю, отключение рекламы, которую вы решили не показывать, и оценку эффективности рекламы.
90 дней
_gcl_gs
Google использует файлы cookie для рекламы, включая показ и отображение рекламы, персонализацию рекламы (в зависимости от настроек рекламы на g.co/adsettings), ограничение количества показов рекламы пользователю, отключение рекламы, которую вы решили не показывать, и оценку эффективности рекламы.
90 дней
_gcl_gb
Google использует файлы cookie для рекламы, включая показ и отображение рекламы, персонализацию рекламы (в зависимости от настроек рекламы на g.co/adsettings), ограничение количества показов рекламы пользователю, отключение рекламы, которую вы решили не показывать, и оценку эффективности рекламы.
90 дней
_gac_gb_
Google использует файлы cookie для рекламы, включая показ и отображение рекламы, персонализацию рекламы (в зависимости от настроек рекламы на g.co/adsettings), ограничение количества показов рекламы пользователю, отключение рекламы, которую вы решили не показывать, и оценку эффективности рекламы.
90 дней
FPGCLGB
Google использует файлы cookie для рекламы, включая показ и отображение рекламы, персонализацию рекламы (в зависимости от настроек рекламы на g.co/adsettings), ограничение количества показов рекламы пользователю, отключение рекламы, которую вы решили не показывать, и оценку эффективности рекламы.
90 дней
FPGCLAW
Google использует файлы cookie для рекламы, включая показ и отображение рекламы, персонализацию рекламы (в зависимости от настроек рекламы на g.co/adsettings), ограничение количества показов рекламы пользователю, отключение рекламы, которую вы решили не показывать, и оценку эффективности рекламы.
90 дней
HubSpot — это универсальная платформа для маркетинга, продаж и обслуживания клиентов, которая способствует росту бизнеса.
Этот файл cookie используется для распознавания посетителей, которые общаются с вами через инструмент chatflows. Если посетитель покидает ваш сайт до того, как его добавили в контакты, этот файл cookie будет связан с его браузером.
13 месяцев.
__hs_do_not_track
Этот файл cookie можно настроить так, чтобы запретить коду отслеживания отправлять какую-либо информацию в HubSpot.
13 месяцев.
__hs_cookie_cat_pref
Этот файл cookie используется для записи категорий, на которые дал согласие посетитель.
6 месяцев.
__hs_initial_opt_in
Этот файл cookie используется для предотвращения постоянного отображения баннера, когда посетители просматривают сайт в строгом режиме.
7 дней
__hs_gpc_banner_dismiss
Этот файл cookie используется при закрытии баннера Глобального контроля конфиденциальности.
180 дней
hs_ab_test
Этот файл cookie используется для последовательного показа посетителям той же версии страницы A/B-тестирования, которую они видели ранее.
Сессия
__hs_notify_banner_dismiss
Этот файл cookie используется, когда веб-сайт использует тип баннера «Уведомление о согласии».
180 дней
HS-сообщения-это открытое
Этот файл cookie используется для определения и сохранения того, открыт ли виджет чата для будущих посещений.
30 минут
HS-сообщения-прятки радушны-сообщение
Этот файл cookie используется для предотвращения повторного появления приветственного сообщения виджета чата в течение одного дня после его закрытия.
1 день
__hsmem
Этот файл cookie устанавливается, когда посетители заходят на сайт, размещенный на HubSpot.
1 год
hs-membership-csrf
Этот файл cookie используется для того, чтобы гарантировать невозможность подделки логинов для участия в контенте.
Сессия
hs_langswitcher_choice
Этот файл cookie используется для сохранения выбранного посетителем языка при просмотре страниц на нескольких языках.
2 лет
__hstc
Основной файл cookie для отслеживания посетителей.
13 месяцев.
hubspotutk
Этот файл cookie отслеживает личность посетителя. Он передается в HubSpot при отправке формы и используется при дедупликации контактов.
13 месяцев.
__hssc
Этот файл cookie отслеживает сеансы.
30 минут
__hssrc
Всякий раз, когда HubSpot изменяет сеансовый cookie-файл, этот cookie-файл также устанавливается для определения того, перезапустил ли посетитель свой браузер.
Сессия
hubspotapi-prefs
Используется совместно с cookie-файлом hubspotapi для запоминания того, отметил ли пользователь флажок «запомнить меня» (контролирует истечение срока действия аутентификации основного cookie-файла).
1 год
hubspotapi-csrf
Используется для предотвращения CSRF-атак — предотвращения доступа сторонних веб-сайтов к вашим данным. Истекает через год.
1 год
__hs_opt_out
Этот файл cookie используется политикой конфиденциальности, чтобы напомнить посетителю о необходимости не запрашивать у него повторное согласие на использование файлов cookie.
13 месяцев.
хабспотапи
Этот файл cookie позволяет пользователю получать доступ к приложению с правильными разрешениями.