Принятие решений на основе данных сегодня является мантрой успеха и совершенства предприятий. От финансовых технологий и производства до розничной торговли и цепочек поставок — каждая отрасль осваивает волну больших данных и принимает решения на основе статистики с помощью своих передовых аналитических моделей и алгоритмов. В сфере здравоохранения это становится еще более полезным и спасающим жизни, служа основой инноваций и научных достижений.
Такой огромный масштаб порождает и проблемы. По мере роста спроса на медицинские данные для различных целей, возрастает и вероятность утечек данных и неправомерного использования конфиденциальной информации. В отчете за 2023 год сообщается о краже более 133 миллионов медицинских записей и данных, что установило новый рекорд по утечкам данных в здравоохранении.
Принятие закона HIPAA стало обнадеживающим шагом в оптимизации защиты конфиденциальности медицинских данных , который сам по себе значительно сократил количество утечек данных на 48% . Отчеты также показывают, что 61% всех утечек данных связаны с халатностью сотрудников и специалистов в этой области.
Для дальнейшего сдерживания подобных атак и массового выявления уязвимостей появляются синтетические данные о пациентах . Как говорится, «современные проблемы требуют современных решений», и появление синтетических данных в здравоохранении позволяет медицинским работникам укреплять данные о пациентах и использовать модели искусственного интеллекта для генерации новых данных.
В этой статье мы подробно разберемся, что такое генерация синтетических данных и каковы ее многочисленные аспекты.
Синтетические данные пациентов: что это такое?
Синтез – это процесс создания чего-то нового путем объединения существующих элементов. В том же контексте синтетические данные пациентов относятся к искусственно созданным данным на основе уже существующих реальных данных пациентов.
В этом процессе статистические модели и алгоритмы изучают большие объемы данных пациентов, наблюдают закономерности и характеристики и генерируют наборы данных, имитирующие реальные данные. Некоторые из распространенных методов, используемых при создании искусственных данных о пациентах, включают:
- Генеративно-состязательные сети (GNN)
- Статистические модели
- Методы анонимизации данных и многое другое
Синтетические данные — отличный и надежный метод, позволяющий обойти проблемы конфиденциальности, связанные с вероятностью раскрытия информации о пациенте, которую можно повторно идентифицировать. Чтобы понять преимущества таких данных, давайте рассмотрим некоторые из наиболее известных случаев использования.
Варианты использования синтетических данных
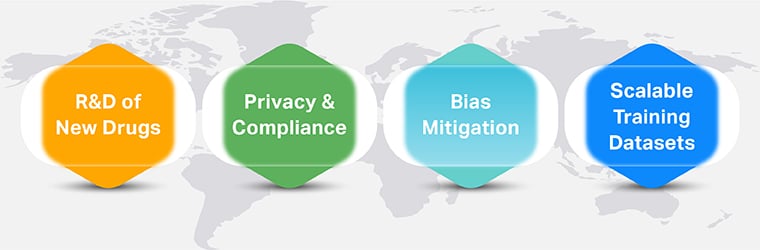
Исследования и разработки новых лекарств и лекарств
Генерация данных клинических испытаний носит конфиденциальный характер, и организации часто скрывают важную информацию. Однако для целей исследований и разработок совместимость данных имеет ключевое значение для достижения прорывов. Генерация синтетических данных может помочь исследователям использовать их для сокрытия важных фрагментов информации, поддающейся повторной отслеживанию, и для разделения данных на отдельные категории, что позволит совместно изучать реакции на лекарственные препараты и их побочные эффекты, состав препаратов, корреляции результатов и многое другое.
Конфиденциальность и соответствие нормативным требованиям
Хотя ведутся разговоры о необходимости централизованных облачных систем EHR, существуют также нормативные проблемы, связанные с проблемами конфиденциальности и безопасности. Хотя совместимость данных неизбежна, заинтересованным сторонам в сфере здравоохранения необходимо проявлять максимальную бдительность при обмене данными о пациентах. Синтетические данные могут помочь скрыть деликатные аспекты, сохраняя при этом ключевые точки соприкосновения и выступая в качестве идеальных репрезентативных наборов данных.
Смягчение предвзятости в здравоохранении
В здравоохранении появление предвзятости является врожденным и неизбежным. Например, если в каком-то географическом регионе произошла эпидемия, затронувшая мужчин в возрасте от 35 до 50 лет, по умолчанию для этого конкретного человека вводится смещение. Хотя женщины и дети по-прежнему уязвимы перед этой вспышкой, исследователям нужна объективная основа для обоснования своих выводов. Синтетические данные могут помочь устранить предвзятость и обеспечить сбалансированное представление.
Масштабируемые наборы данных для обучения в сфере здравоохранения
Из-за таких правил, как GDPR, HIPAA и других, доступность наборов данных для обучения передовых моделей машинного обучения, ориентированных на здравоохранение, остается ограниченной. Системы искусственного интеллекта (ИИ) и модели машинного обучения требуют огромных объемов обучающих данных, чтобы постоянно совершенствоваться в предоставлении точных результатов.
Генерация синтетических данных — настоящее благо в этой области, позволяющее организациям создавать искусственные данные, адаптированные к их потребностям в объеме, спецификациям и результатам, и одновременно поощрять этичное использование синтетических данных.
Недостатки и подводные камни синтетических данных здравоохранения
Тот факт, что существуют системы и модули для искусственного создания данных о пациентах и здравоохранении из существующих наборов данных, обнадеживает. Однако эта технология не лишена изрядной доли недостатков. Давайте разберемся, что они собой представляют.