
В физическом ИИ модель редко является узким местом — им являются данные. Политика робота, которая безупречно работает в демонстрационном режиме, а затем зависает в реальном складском помещении, почти всегда терпит неудачу из-за данных, которых она никогда не видела, а не из-за архитектуры. Это ставит перед каждой командой робототехников вопрос бюджета: при выборе между синтетическими и реальными данными для робототехники, что же на самом деле следует приобрести? У обоих есть реальные преимущества, у обоих есть реальные затраты, и правильный ответ зависит от текущего состояния вашего проекта.
Основные выводы
- Синтетические данные — это недорогой, масштабируемый и безопасный способ генерации больших объемов данных для решения нестандартных ситуаций.
- Данные из реальных условий позволяют учесть шумы датчиков и изменчивость с длинным хвостом распределения, которые не учитываются при моделировании.
- Разрыв между симуляцией и реальностью — главная причина, по которой модели, созданные исключительно на основе синтетических данных, терпят неудачу при внедрении.
- Стоимость сбора данных в реальных условиях зависит от количества часов, затраченных на сбор; синтетические данные, после создания, масштабируются дешево.
- Синтетические данные заполняют пробелы; данные из реального мира служат основой для обучения. Гибридный подход одержит победу в 2026 году.
- Приобретайте синтетические данные на ранних этапах, покупайте данные из реальных условий эксплуатации, прежде чем приступать к тонкой настройке и развертыванию.
Что такое синтетические данные для робототехники?

Синтетические данные для робототехники — это искусственно сгенерированные обучающие данные, полученные в ходе моделирования, а не собранные с реальных роботов. Физический движок или модель мира отображает сцены, движение и показания датчиков, а также автоматически присваивает каждому кадру метку, соответствующую точным эталонным данным.
Поскольку симулятор точно знает положение, массу и движение каждого объекта, он создает безупречные метки со скоростью, недостижимой при ручной обработке данных. Синтетические данные охватывают четыре основных типа: зрение (сегментированные изображения, различное освещение), 3D и глубина (облака точек, навигационные карты), движение (траектории, углы сочленений, скорость) и взаимодействие (захват, контакт, столкновение). Рандомизация домена — преднамеренное изменение цветов, текстур и освещения за пределами реалистичных диапазонов — заставляет модели фокусироваться на релевантных для задачи признаках.
Рандомизация домена: метод, который изменяет внешний вид симуляции за пределами реалистичных ограничений, чтобы модели могли обобщаться на реальные условия, которые им никогда явно не демонстрировались.
[Также читайте: Набор данных физического ИИ ]
Что представляют собой данные из реального мира для робототехники?
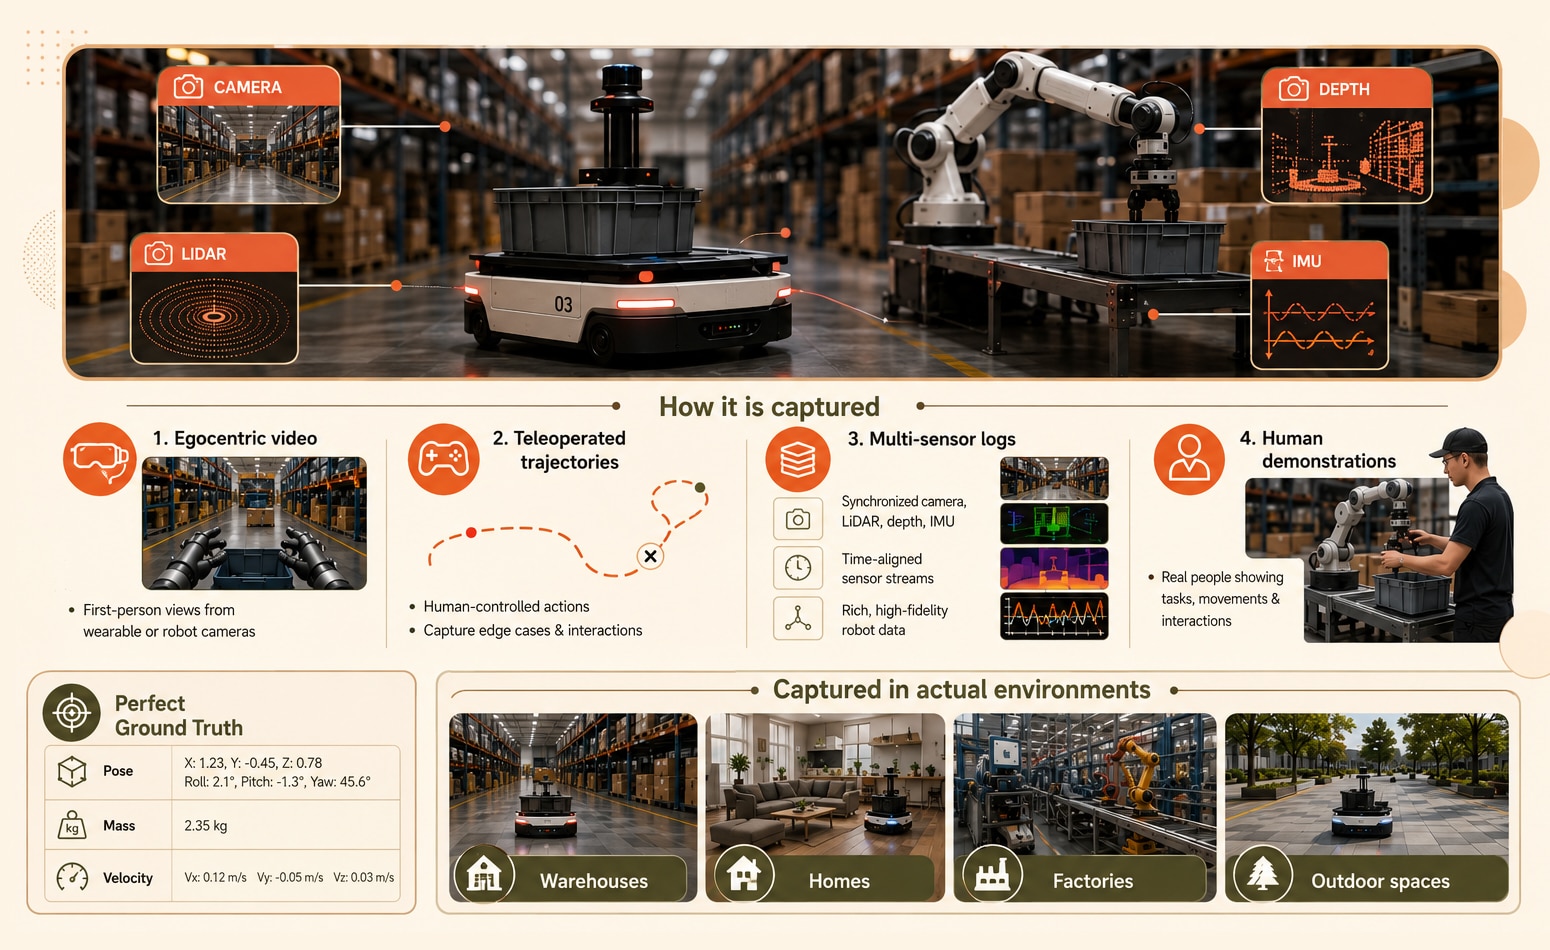
Данные, полученные в реальных условиях для робототехники, — это обучающие данные, собранные с помощью физических датчиков, дистанционного управления или демонстраций человека в реальных условиях. Они содержат истинный шум, изменения освещения и непредсказуемую изменчивость, с которыми робот сталкивается в момент выхода из лаборатории.
Это данные, которые позволяют модели оставаться в рамках реальности. Они включают эгоцентрическое (от первого лица) видео, траектории телеуправляемых манипуляций, многосенсорные журналы, объединяющие потоки с камер, лидаров, датчиков глубины и инерциальных измерительных блоков, а также записи демонстраций, выполненных людьми. Сбор данных Шаипа в реальных условиях охватывает эгоцентрическое видео, телеуправление и захват манипуляций в различных глобальных средах — именно те сценарии с высокой степенью вариативности, которые моделирование с трудом воспроизводит.
Эгоцентрические данные: видеозаписи от первого лица и данные с датчиков, полученные с помощью камер, закрепленных на голове, груди или запястье, которые отражают то, что видит робот во время выполнения задачи.
Синтетические данные против реальных данных: как они соотносятся?
Синтетические и реальные данные решают противоположные задачи. Синтетические данные выигрывают по стоимости, масштабируемости и охвату нестандартных ситуаций; реальные данные выигрывают по реалистичности, точности датчиков и надежности при развертывании. В таблице ниже показаны компромиссы, которые покупатели учитывают в первую очередь.
В чём заключается разрыв между симуляцией и реальностью — и почему это важно?
Разрыв между симуляцией и реальностью — это падение производительности, которое происходит, когда модель, обученная в симуляции, сталкивается с реальными условиями, которые ее обучение никогда не воспроизводило. Это главная причина, по которой модели робототехники, созданные исключительно на основе синтетических моделей, выходят из строя в производстве.
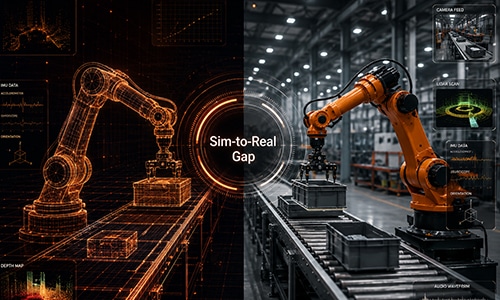
Представьте себе пилота, который летал только на симуляторе. Он может безупречно выполнить любой сценарий, но как только он впервые столкнется с реальной турбулентностью — той, которую сглаживал симулятор, — его подготовка покажет свои пределы. Роботы ведут себя точно так же: система, освоившая чистый виртуальный склад, может зависнуть, когда реальный погрузчик появляется под неучтенным углом или когда солнечный свет заливает датчик таким образом, что рендерер его не зафиксировал.
В моделировании используются упрощенные физические предположения, и оно редко моделирует артефакты датчиков, граничные случаи материалов или действительно неблагоприятные условия. Данные из реального мира восполняют этот пробел, закрепляя модель в широком диапазоне изменчивости, который присутствует только при физическом захвате.
[Также читайте: Что требуется моделям VLA от обучающих данных ]
Как соотносятся стоимость синтетических и реальных данных?
Разница в стоимости между синтетическими и реальными данными носит структурный характер, а не сводится только к цене. Синтетические данные требуют высоких первоначальных затрат на создание конвейера генерации, после чего предельные затраты на каждый дополнительный кадр сводятся к одним лишь вычислительным ресурсам. С реальными данными ситуация обратная: стоимость масштабируется примерно линейно с каждым часом физического захвата и каждой размеченной последовательностью.
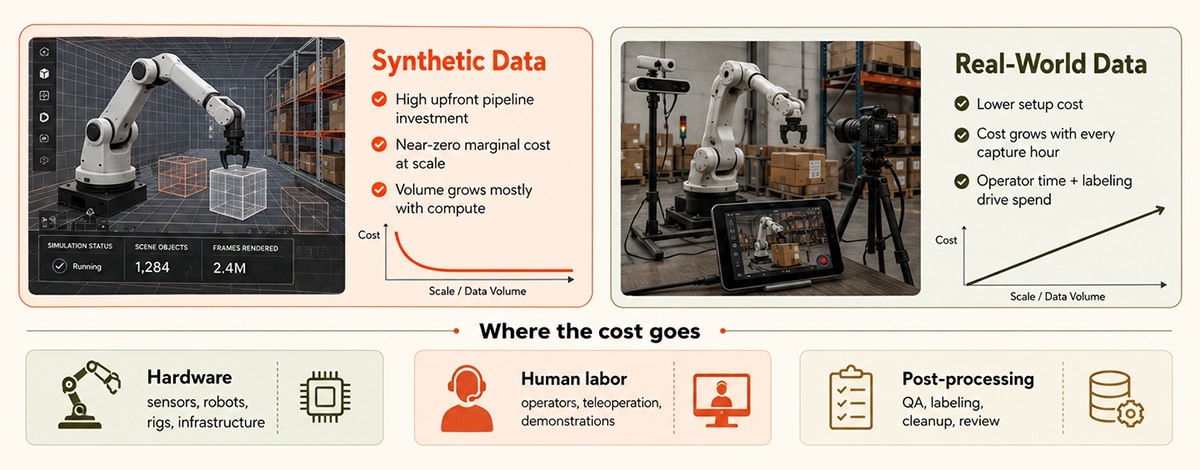
Стоимость обучающих данных для роботов делится на три категории — оборудование, человеческий труд и постобработка — и баланс между ними зависит от вашего подхода:
- Синтетический подход: высокие первоначальные инвестиции в разработку, практически нулевые предельные издержки при масштабировании объемов.
- В реальных условиях: меньшие затраты на подготовку, но стоимость возрастает с каждым часом сбора данных, временем работы оператора и маркировкой.
- Гибридный подход: синтетические данные обрабатывают большие объемы информации; реальные затраты концентрируются там, где реализм имеет наибольшее значение.
Эта асимметрия лежит в основе решения о покупке. Синтетические данные позволяют масштабировать систему с минимальными затратами после создания конвейера разработки, в то время как на основе реальных данных бюджет концентрируется по мере приближения к развертыванию. Однако более низкая стоимость не означает более низкий риск — и именно здесь решение становится более сложным.
Что следует приобрести для вашего проекта, связанного с физическим искусственным интеллектом?
Приобретайте синтетические данные, когда вам необходимы масштабируемость, безопасность и скорость на ранних этапах разработки; приобретайте данные из реального мира, когда вам нужно сократить разрыв между симуляцией и реальными данными перед доработкой и развертыванием. Разделение должно определяться этапом вашего проекта, а не идеологией.
Представьте себе логистическую компанию среднего размера, разрабатывающую автономного мобильного робота для нового центра выполнения заказов. На начальном этапе у них нет оборудования на площадке, поэтому они почти полностью полагаются на синтетические данные — генерируя тысячи виртуальных схем проходов, разливов и ситуаций, близких к аварии с погрузчиком, чтобы предварительно обучить робота восприятию и безопасной навигации. С прибытием первых физических устройств ситуация меняется: они инвестируют в создание реальных данных о своем предприятии, чтобы точно настроить поведение с учетом особенностей, которые не мог предсказать ни один симулятор — отражающие полы, блики на погрузочной площадке в 16:00, поддон, обернутый необычной пленкой. Синтетические данные позволили им начать работу; данные из реального мира сделали их готовыми к развертыванию.
Практическая модель принятия решений:
- На этапе подготовки оборудования или на ранних стадиях исследований и разработок → предпочтение синтетическим тестам для предварительного обучения и стресс-тестирования.
- Редкие, опасные или конфиденциальные сценарии → создание синтетических моделей для их безопасного массового производства.
- Тонкая настройка для конкретной среды → реальные данные из этой среды.
- Проверка и сертификация безопасности → данные из реальных условий эксплуатации, каждый раз.
Почему гибридная стратегия работы с данными в робототехнике окажется успешной в 2026 году
Гибридная стратегия работы с данными в робототехнике использует синтетические данные для заполнения конкретных пробелов, одновременно основывая обучение на реальных данных, что позволяет модели учитывать подлинную изменчивость. Именно к такому подходу приходят производственные группы, когда пилотные проекты, использующие только синтетические данные, сталкиваются с проблемой перехода от симуляции к реальным данным.
Логика проста. Синтетические данные обеспечивают объем и учет крайних случаев; данные из реального мира обеспечивают реализм и доверие. Shaip основывает физические программы ИИ на реальных демонстрациях и эгоцентрических данных, одновременно поддерживая генерацию синтетических данных для широкого круга задач — таким образом, команды получают масштабируемость без ущерба для устойчивости робота на рабочем месте. Для команд, которым быстро требуются готовые наборы данных, лицензирование готовых данных может еще больше сократить этот путь.
Как оценить партнера по предоставлению данных в области робототехники?
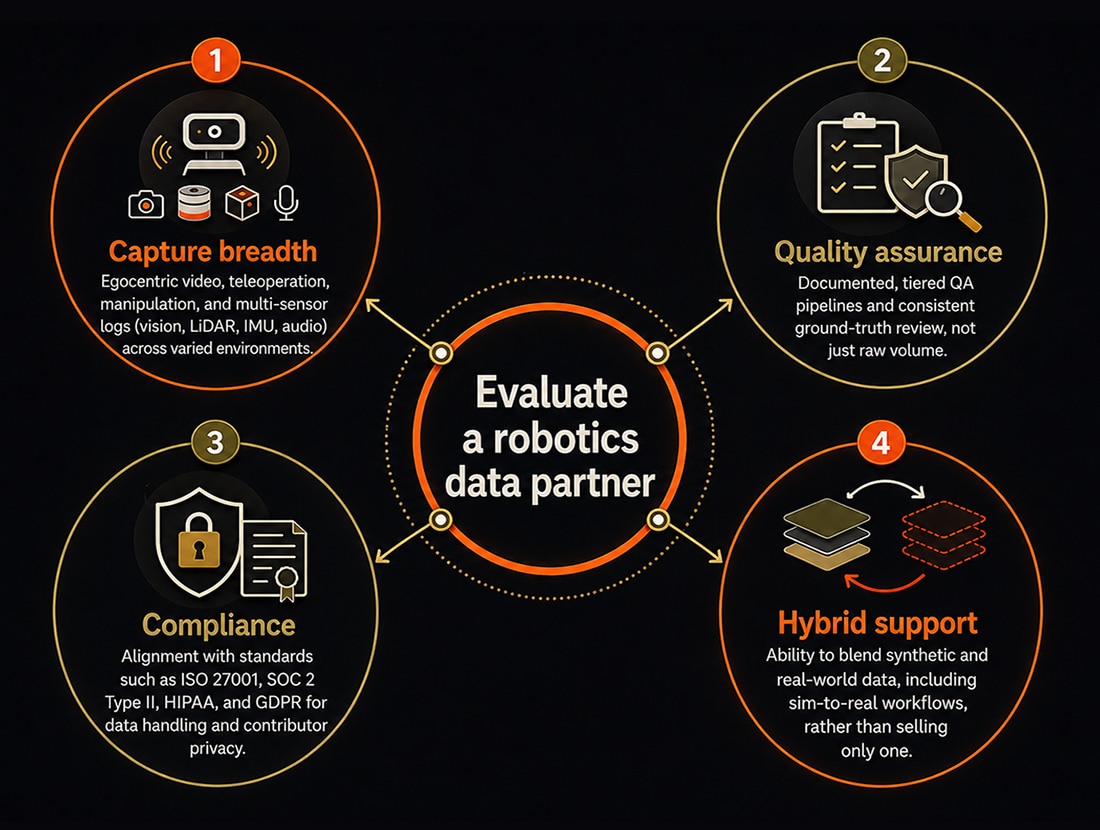
Оценивайте партнера по сбору данных для робототехники по таким критериям, как возможности сбора данных в реальных условиях, охват вариантов реализации, обеспечение качества и соответствие нормативным требованиям, а не только по цене. Поскольку сбор данных в реальных условиях затрагивает чувствительные среды и людей, безопасность и управление данными имеют такое же значение, как и точность маркировки.
- Обеспечение широкого охвата: эгоцентрическое видео, телеуправление, манипуляции и многосенсорные журналы (зрение, LiDAR, IMU, аудио) в различных условиях.
- Обеспечение качества: документированные, многоуровневые конвейеры контроля качества и последовательная проверка на основе фактических данных, а не просто анализ необработанного объема информации.
- Соответствие стандартам: соответствие таким стандартам, как ISO 27001, SOC 2 Type II, HIPAA и GDPR, в отношении обработки данных и конфиденциальности данных участников.
- Поддержка гибридных решений: возможность сочетать синтетические и реальные данные, включая рабочие процессы от моделирования к реальности, вместо продажи только одного из вариантов.
По каждому из этих критериев сервисы обработки данных физического ИИ от Shaip созданы для команд, занимающихся робототехникой и воплощенным ИИ, в качестве комплексного партнера, охватывающего многомодальный сбор данных, сложную аннотацию VLA и действий, генерацию синтетических данных, RLHF и оценку в рамках одного проекта. Shaip собирает данные из реальных сред, где фактически работают модели — кухонь, складов, заводов, улиц и медицинских учреждений — через управляемую глобальную сеть сбора данных, а не посредством открытого краудсорсинга, с соблюдением стандартов ISO 27001, SOC 2 Type II, соответствием требованиям HIPAA и GDPR.
Этот опыт проявляется в масштабах. В одной из программ по созданию человекоподобных роботов компания Shaip разработала полную инфраструктуру для обработки данных — настройку сцены с помощью QR-кодов, отслеживание с помощью пяти датчиков, модерируемую репетицию и готовый к использованию контроль качества моделей — для генерации 10 000 часов эгоцентрических данных о движении в виртуальной реальности для примерно 4,000 участников и 100 задач всего за 30 дней. Прочитайте полное описание проекта , чтобы узнать, как была структурирована программа от настройки до готовности к развертыванию.





