
В основе корпоративного ИИ лежит тихая ирония: самые умные модели в мире не помогут вам, если ваши данные заперты в отсканированном счете-фактуре, факсимильном отчете лаборатории или рукописной накладной. А по оценкам, около 80% бизнес-данных хранится именно в таких неструктурированных документах.
Оптическое распознавание символов (OCR) — это технология, которая освобождает эти данные. И в 2026 году она переживает свой звездный час. По прогнозам, к 2033 году мировой рынок OCR достигнет 55.3 млрд долларов, по сравнению с 13.1 млрд долларов в 2023 году, и будет расти на 15.5% в год. Современные системы распознавания символов обычно достигают точности 98–99% на уровне страницы. То, что когда-то было неуклюжей утилитой сканирования, стало универсальным инструментом для автоматизации предприятий.
Вот как выглядит OCR сегодня: как он работает, какие существуют типы, какие изменения внес искусственный интеллект и куда он движется.
Что такое OCR?
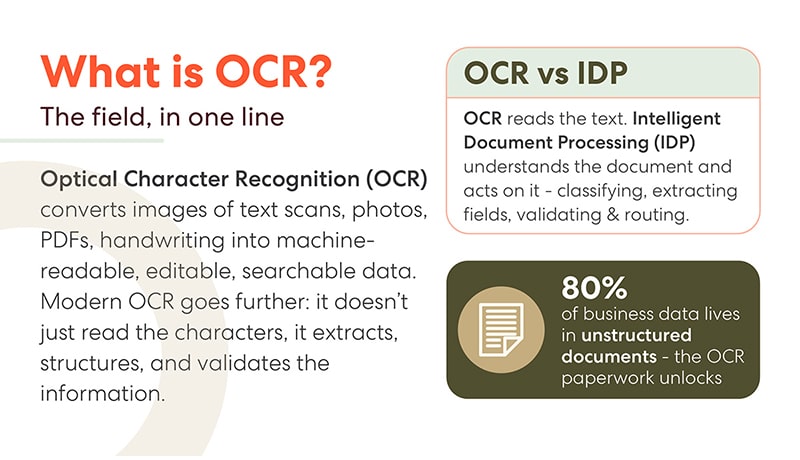
Технология оптического распознавания символов преобразует изображения текста — сканы, фотографии, PDF-файлы, рукописный текст — в машиночитаемые, редактируемые и доступные для поиска данные. Это классическое определение, и оно не отражает того, что происходит на самом деле в 2026 году.
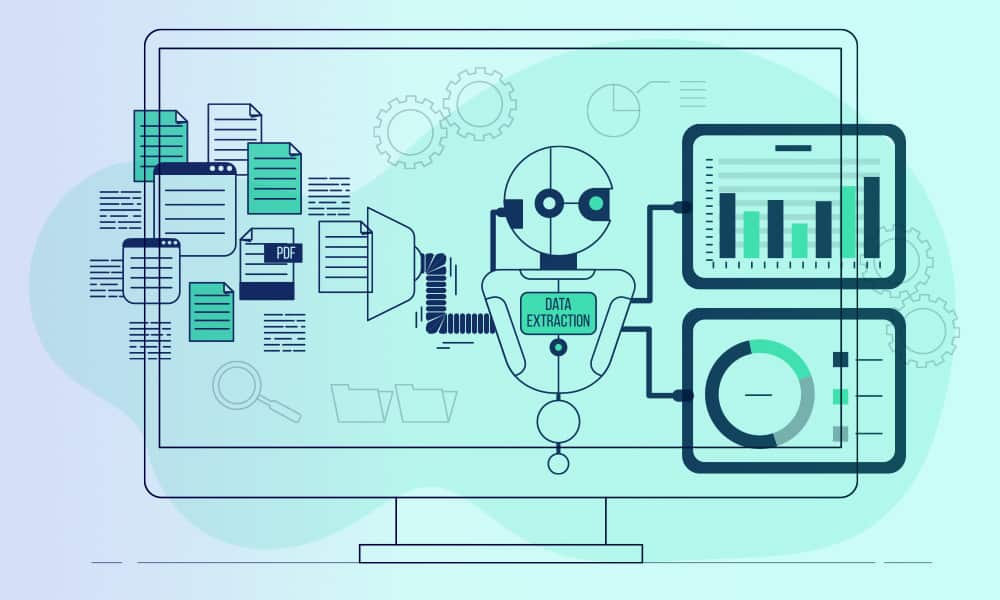
Современные технологии оптического распознавания символов (OCR) не просто считывают символы. Они извлекают структуры — поля, таблицы, позиции — и проверяют достоверность полученной информации. Если вы передадите им на вход смятый счет-фактуру, сфотографированный на телефон, они вернут не просто текстовый блок, а структурированную запись: поставщик, дата, позиции, итоговая сумма, каждая с оценкой достоверности.
OCR против IDP: важное различие
Оба термина вы услышите в каждом разговоре с поставщиками, поэтому вот в чем разница. OCR считывает текст. Интеллектуальная обработка документов (IDP) понимает документ и действует на его основе — классифицирует его тип, извлекает важные поля, проверяет их на соответствие бизнес-правилам и направляет результат в нужную систему.
Представьте себе OCR как глаза, а IDP — как мозг. Один без другого дает лишь половину результата: идеально расшифрованный текст, который все равно нуждается в интерпретации человеком, или интеллектуальный рабочий процесс, испытывающий недостаток читаемого ввода. Рынок уверенно движется в сторону комбинирования.
Как работает оптическое распознавание символов (OCR): современный 6-шаговый процесс.
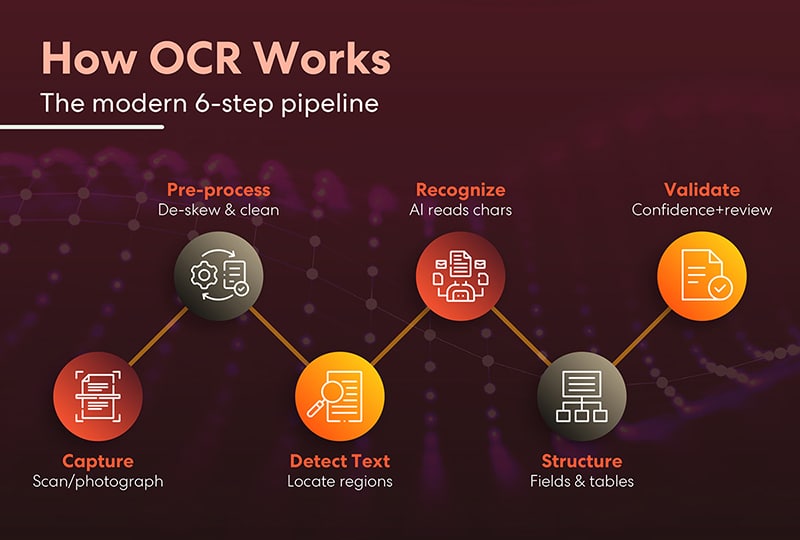
Современные системы оптического распознавания символов (OCR) используют шестиэтапный конвейер обработки данных, и понимание этого помогает объяснить как причины резкого роста точности, так и места, где всё ещё возникают ошибки.
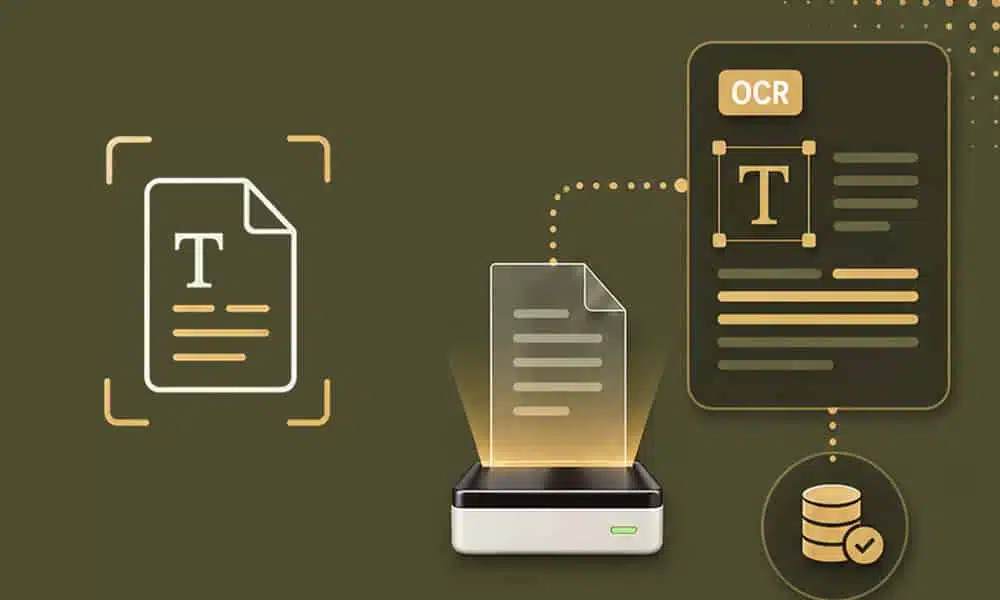
Процесс начинается с захвата — сканирования или фотографирования документа. Затем выполняется предварительная обработка, которая очищает изображение: устраняет искажения наклоненных страниц, удаляет шумы и корректирует контраст, поскольку качество распознавания зависит от качества исходного изображения. Далее, распознавание текста определяет области страницы, содержащие текст, отделяя слова от логотипов, штампов и фона. Затем следует распознавание , где ИИ считывает символы — этап, который большинство людей считают «оптическим распознаванием текста» (OCR). Но современный конвейер обработки на этом не останавливается. Структурирование преобразует исходный текст в поля и таблицы, превращая «слова на странице» в «данные в схеме». Наконец, проверка включает оценку достоверности и анализ, отмечая все неясные моменты для человека до того, как они попадут в ваши системы.
Захват → предварительная обработка → обнаружение → распознавание → структура → проверка. Последние два шага отличают OCR-технологии 2026 года от программного обеспечения для сканирования десятилетней давности.
Типы оптического распознавания символов: не все методы распознавания одинаковы.
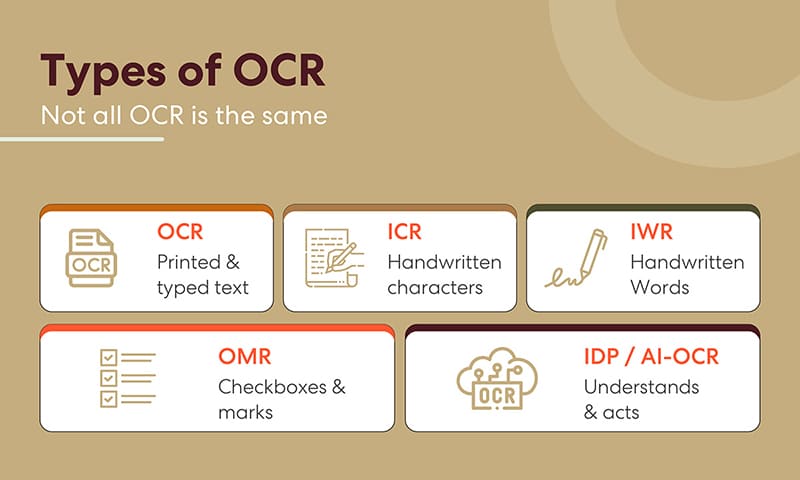
Термин «OCR» часто используется как общее обозначение, но в этой области выделяют несколько технологий, каждая из которых подходит для обработки различного контента.
Технология OCR (Output Online Signal) обрабатывает печатный и набранный текст — это самый простой и наиболее отработанный случай. ICR (Intelligent Character Recognition) считывает рукописные символы, что является одной из самых сложных задач в этой области. IWR (Intelligent Word Recognition) идет еще дальше, распознавая целые рукописные слова, а не отдельные буквы — лучше подходит для курсива, где символы сливаются воедино. OMR (Optical Mark Recognition) считывает флажки и отметки, эта технология используется в формах и бланках ответов. А IDP/AI-OCR находится на вершине стека: системы, которые не просто читают, но и понимают и действуют.
Первым делом в любом проекте по распознаванию текста необходимо определить, какой тип документов вам нужен. Распечатанный счет-фактура и рукописный рецепт врача — это совершенно разные задачи.
Оптическое распознавание символов в эпоху ИИ: распознавание необработанных данных — это только первый шаг.
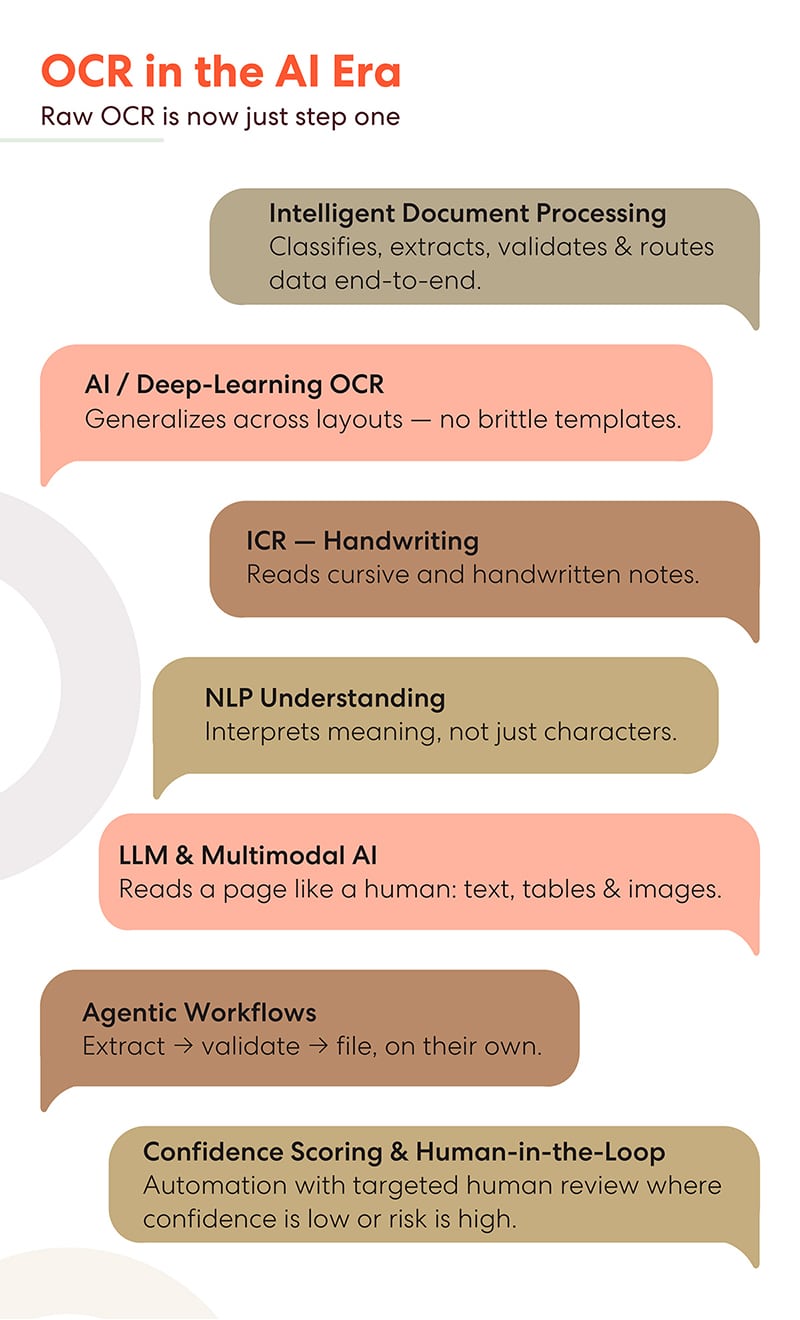
Самое существенное изменение в этой области заключается в том, что распознавание символов — некогда весь продукт — теперь является лишь отправной точкой. Современный искусственный интеллект для работы с документами определяет семь его возможностей.
Интеллектуальная обработка документов охватывает весь процесс от начала до конца: классификацию документов, извлечение полей, проверку данных и маршрутизацию результатов без ручной передачи.
Искусственный интеллект и глубокое обучение в области оптического распознавания текста позволяют создавать универсальные шаблоны для разных типов документов. Более старым системам требовался ненадежный шаблон для каждого формата документа; современные модели обрабатывают счета-фактуры, которые они никогда раньше не видели, поскольку они уже научились определять, как выглядят счета-фактуры в целом.
Технология распознавания рукописного текста ICR достигла такого уровня зрелости, что позволяет читать рукописные заметки и тексты, написанные курсивом, — открывая доступ к медицинским записям, накладным и архивным документам, которые ранее были недоступны.
Система НЛП интерпретирует смысл, а не просто символы. Она не просто переписывает «Net 30» — она знает, что это условие оплаты.
LLM-системы и мультимодальный ИИ читают страницу так же, как человек: текст, таблицы и изображения вместе, в контексте. Это самый новый и быстро развивающийся уровень в этой системе.
В агентских рабочих процессах цикл замыкается: извлечение → проверка → файл, автономно. Документ не просто читается; он обрабатывается.
Оценка достоверности с участием человека делает всю эту систему безопасной для внедрения. Автоматизация происходит там, где уровень достоверности высок; люди проверяют только там, где уровень достоверности низок или риск высок. Именно такая модель целенаправленной проверки позволяет предприятиям одновременно повышать скорость и обеспечивать возможность аудита.
Примеры применения оптического распознавания символов: где оно приносит пользу.
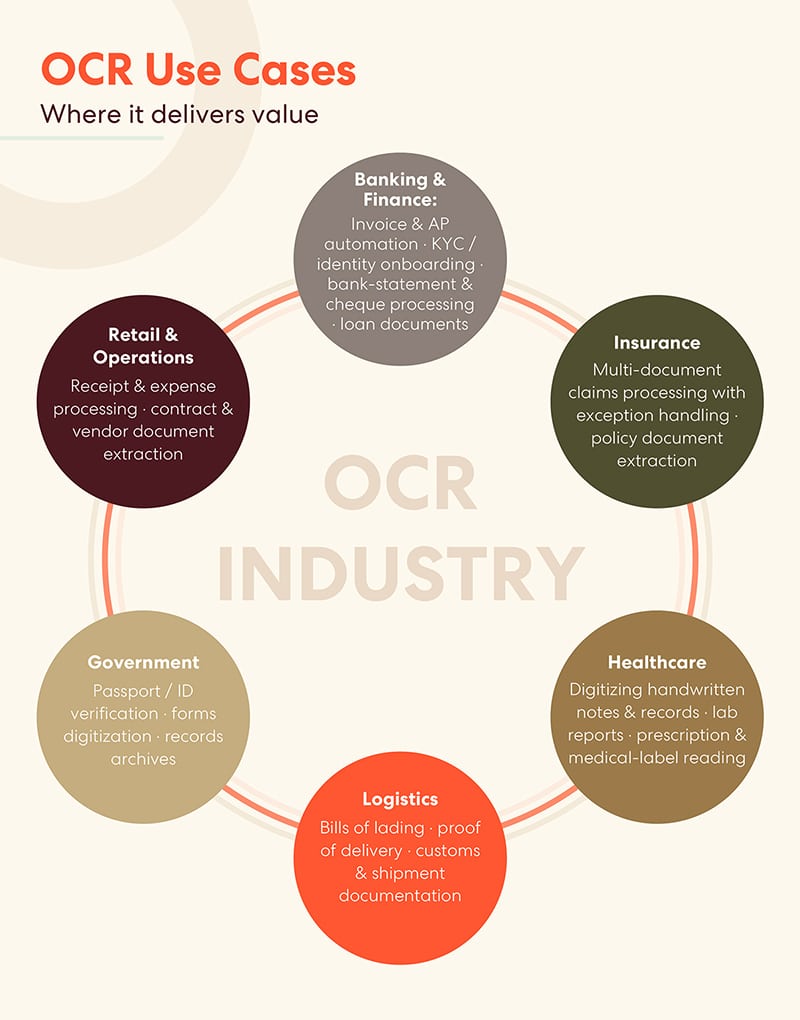
Отрасли, которые быстрее всего внедряют технологию оптического распознавания символов (OCR), — это те, которые тонут в бумажном производстве.
Банковский и финансовый сектор лидирует на рынке — автоматизация обработки счетов и расчетов с поставщиками, проверка личности клиента (KYC) и регистрация идентификационных данных, обработка банковских выписок и чеков. Не случайно, что BFSI (банковский, финансовый и страховой секторы) является крупнейшим сегментом рынка OCR, занимая примерно 21%. Страхование использует его для обработки многодокументных заявок с обработкой исключений и извлечением данных из страховых полисов — одна заявка может включать десятки документов в разных форматах. В здравоохранении OCR оцифровывает рукописные заметки и записи, считывает результаты лабораторных анализов и обрабатывает рецепты и медицинские этикетки, где точность буквально является вопросом безопасности. Логистика работает с документами — коносаментами, подтверждениями доставки, таможенными и транспортными документами — и OCR обеспечивает бесперебойное движение товаров, предотвращая превращение бумажной работы в узкое место. Государственный сектор применяет его для проверки паспортов и удостоверений личности, обработки форм и оцифровки архивных записей. А в розничной торговле и операционной деятельности он обеспечивает обработку поступлений и расходов, а также извлечение данных из контрактов и поставщиков.
Общая тенденция для всех шести систем: везде, где раньше человек перепечатывал информацию с бумаги в систему, теперь это делает OCR быстрее, дешевле и с сохранением контрольного журнала.
Преимущества и недостатки: честная картина
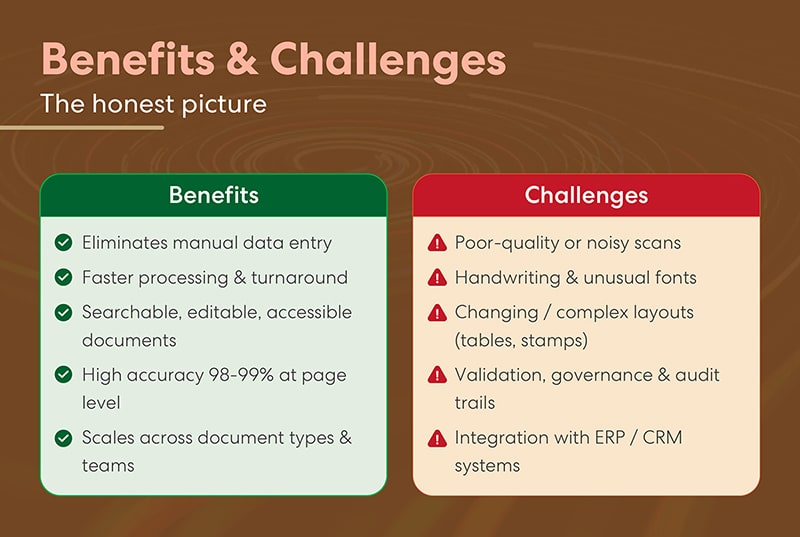
Преимущества очевидны. OCR исключает ручной ввод данных — самую подверженную ошибкам и наименее любимую работу в любом бэк-офисе. Обработка и срок выполнения значительно ускоряются. Документы становятся доступными для поиска, редактирования и просмотра, а не представляют собой некачественные отсканированные изображения. Точность теперь достигает 98–99% на уровне страницы. А современные системы масштабируются для разных типов и форматов документов, не «застревая» на чем-либо незнакомом.
Однако реальные внедрения по-прежнему сталкиваются с реальными проблемами. Низкое качество или шум при сканировании остаются главной причиной снижения точности — ни одна модель не сможет прочитать то, что неразборчиво. Рукописный текст и необычные шрифты по-прежнему отстают от печатного текста. Изменяющиеся и сложные макеты — вложенные таблицы, штампы, многоколоночные формы — затрудняют извлечение данных. Проверка, управление и журналы аудита требуют реальных инженерных усилий, особенно в регулируемых отраслях. А интеграция с системами ERP и CRM — это то, где многие проекты заходят в тупик: извлечение данных полезно только в том случае, если они попадают туда, где фактически выполняется работа.
Ни один из этих факторов не является критическим. Именно поэтому существуют системы оценки достоверности и проверка человеком, а также качество документов и хорошо аннотированные обучающие данные, которые так же важны, как и выбор модели.
Рынок оптического распознавания символов: исходные данные и текущие показатели.
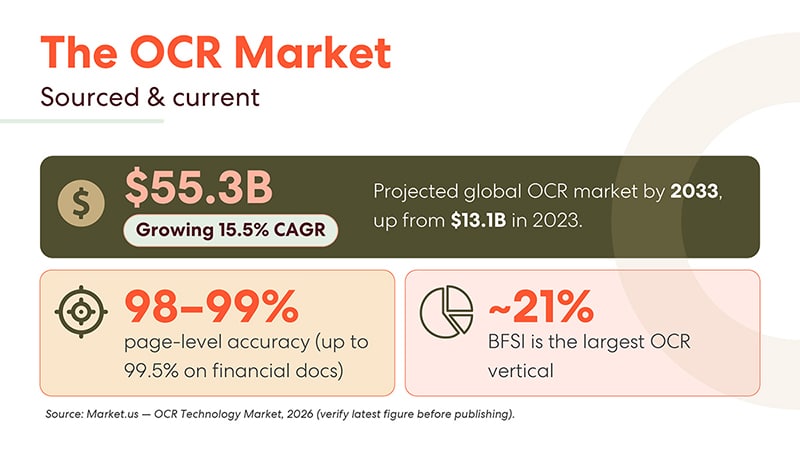
Цифры отражают открывающиеся возможности. По прогнозам, к 2033 году объем мирового рынка оптического распознавания текста (OCR) достигнет 55.3 млрд долларов , увеличившись с 13.1 млрд долларов в 2023 году — среднегодовой темп роста составляет 15.5% . Точность распознавания текста на уровне отдельных страниц достигла 98–99% , и этот показатель еще выше для финансовых документов. А банковский и финансовый сектор (BFSI) является крупнейшим сегментом, занимая около 21% рынка, что свидетельствует о том, что именно здесь окупаемость инвестиций проявляется в первую очередь.
Что дальше: тенденции в области оптического распознавания символов (OCR) на 2026 год
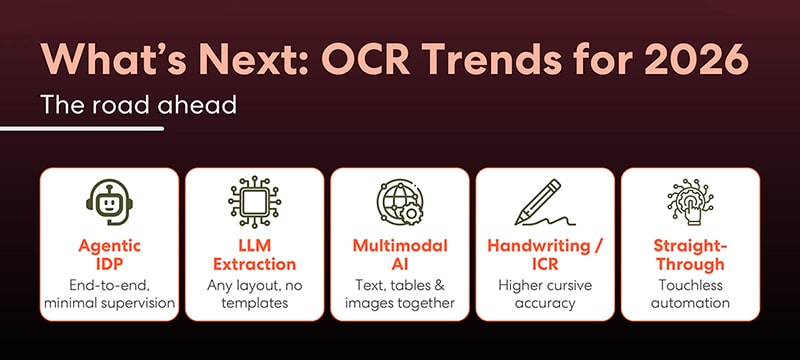
Пять тенденций определяют будущее. Агентная обработка информации — рабочие процессы обработки документов, которые выполняются от начала до конца без участия человека на этапе "идеального результата". Извлечение данных на основе LLM — использование больших языковых моделей для извлечения структурированных данных из документов с минимальной или нулевой настройкой шаблонов. Мультимодальный ИИ — модели, которые обрабатывают текст, таблицы и изображения за один проход, понимая документы как единое целое, а не как фрагменты. Достижения в области рукописного ввода и ICR — неуклонное повышение точности распознавания рукописного и неразборчивого почерка, открывающее доступ к классам документов, которые ранее обрабатывались только вручную. И сквозная обработка — конечная цель: документы, которые поступают, читаются, проверяются и архивируются без участия человека.
Направление не вызывает сомнений: от чтения документов до работы с ними.
Выводы
В 2026 году оптическое распознавание текста (OCR) — это уже не просто преобразование изображений в текст, а превращение бумажных документов в готовые рабочие документы. Учитывая, что 80% бизнес-данных хранятся в неструктурированных документах, а рынок приближается к 55 миллиардам долларов, для большинства организаций вопрос заключается не в том, следует ли внедрять OCR, а в том, насколько высоко в технологической цепочке следует продвинуться: извлечение обычного текста, структурированные документы или полностью автоматизированные рабочие процессы обработки документов.
Документы уже накапливаются. Технология для их чтения и принятия мер на их основе уже готова.