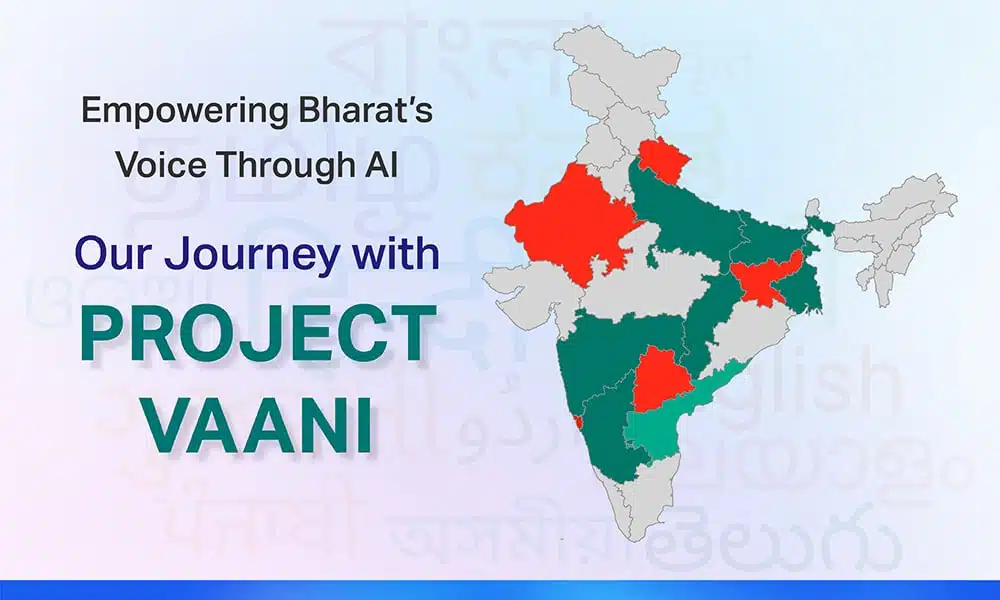
В такой культурно разнообразной и лингвистически богатой стране, как Индия, создание инклюзивного ИИ начинается со сбора репрезентативных, высококачественных наборов данных. Именно в этом заключается идея проекта Vaani — масштабной инициативы с открытым исходным кодом, возглавляемой ARTPARK , IISc Bengaluru и Google , цель которой — дать голос каждому индийскому языку и диалекту.
Амбициозная цель? Собрать более 150 000 часов устных выступлений и более 15 000 часов транскрипций от 1 миллиона человек в 773 районах Индии.
Как один из ключевых поставщиков в рамках этой национальной миссии, компания Shaip сыграла решающую роль в обработке данных спонтанной речи, транскрипции и сборе метаданных, заложив основу для создания справедливых голосовых технологий, которые действительно отражают реальную Индию.
Видение проекта Vaani
Проект Vaani призван преодолеть разрыв в доступности ИИ путем создания крупнейшего в Индии многомодального, многоязычного набора данных с открытым исходным кодом . Эти данные являются основой для разработки точных систем распознавания речи, перевода и генеративного ИИ на родных индийских языках, многие из которых недостаточно представлены в глобальных технологических экосистемах.
Долгосрочная цель — создание эффективных приложений в следующих областях:
- Здравоохранение – Голосовая телемедицина
- Образование – Платформы обучения на родном языке
- Управление – Диалоговые интерфейсы для обслуживания граждан
- Доступность – Голосовые инструменты для пользователей с ограниченными возможностями
- Реагирование на бедствия – Общение в реальном времени на местных диалектах
Как Шаип помог создать крупнейший в Индии открытый исходный набор речевых данных для проекта Vaani
Компании Shaip было поручено собрать 8,000 часов спонтанной речи и 800 часов вручную проверенных транскрипций . В наши обязанности входили подбор говорящих, запись аудио, присвоение метаданных, координация транскрипции и контроль качества.
8,000 часов спонтанных аудиоданных
Записи разговоров более чем 400 носителей языка из каждого района, представляющих различные возрастные группы, пол и диалекты.
80 районов, охваченных
Использование визуальных подсказок для обеспечения естественной, контекстуальной речи.
Вот что сделало наш подход уникальным:
Разнообразие на уровне округа
Мы получили записи из 80 округов, расположенных в таких штатах, как Бихар, Уттар-Прадеш, Карнатака, Западная Бенгалия и Махараштра. Каждый округ предоставил 100 часов аудиоданных, обеспечив региональный баланс. Мы привлекли носителей языка, обеспечив представление региональных акцентов и диалектов, которые часто упускаются из виду в основных наборах данных ИИ.
Лингвистическое и демографическое представительство
Мы получили записи из 80 округов, расположенных в таких штатах, как Бихар, Уттар-Прадеш, Карнатака, Западная Бенгалия и Махараштра. Каждый округ предоставил 100 часов аудиоданных, обеспечив региональный баланс. Мы привлекли носителей языка, обеспечив представление региональных акцентов и диалектов, которые часто упускаются из виду в основных наборах данных ИИ.
Речь, подсказываемая изображениями
Чтобы стимулировать спонтанный и естественный словарный запас, участникам показывали 45–90 изображений за сеанс и просили их описать. Участникам предлагалось использовать разнообразные изображения — от культурных символов до повседневных предметов — для получения естественных, спонтанных ответов на их родном языке. Это гарантировало, что записи отражают реальную, контекстную речь — необходимую для обучения продвинутых систем НЛП.
Стандарты высококачественной транскрипции
Только 10% речевых данных были транскрибированы — что составило 800 часов. Транскрибирование выполнялось местными лингвистами в радиусе 20–50 км от говорящего, что обеспечивало знание диалектов и нюансов. Проверка второго уровня обеспечивала <5% ошибок в словах (WER).
Строгий контроль качества
Аудиоданные должны были соответствовать высоким стандартам: без фонового шума, эха, вибраций телефона или искажений. Аудио записывалось в тихой обстановке без эха. Файлы проходили строгую проверку на соответствие требованиям к четкости речи, уровню шума, точности метаданных и проверке говорящего. Метаданное тегирование должно было быть точным во всех файлах, и все записи проверялись на соответствие говорящему и местоположению.

Проблемы, которые мы решили
- Удаленная логистика – Управление командами в 80 округах
- Разнообразие говорящих – Привлечение более 32,000 XNUMX проверенных спикеров в отдаленных регионах
- Культурная чувствительность – Уважение местных обычаев и диалектов
- Целостность данных – Соблюдение стандартов качества и соответствия
- Контроль качества – в различных языковых и культурных контекстах
Наш успех стал возможен благодаря тщательному планированию, технологической проверке и партнерству с местными командами, которые понимают культурные особенности каждого региона.
Влияние и применение
Вклад Шаипа не только ускорил прогресс проекта Vaani, но и заложил основу для инклюзивного ИИ в Индии. Отобранный набор данных о речи уже используется для создания и настройки моделей ИИ для:
- Народные голосовые помощники
- Региональные системы перевода
- Доступные средства коммуникации для людей с нарушениями зрения
- Платформы образовательных технологий на основе искусственного интеллекта для сельских студентов
- Сельская телемедицина
- Голосовые услуги для граждан
- Перевод и транскрипция в реальном времени
Заключение
Проект Vaani — это смелый шаг на пути к инклюзивному и доступному искусственному интеллекту, и компания Shaip гордится тем, что играет в нем основополагающую роль. Работа Shaip над проектом Vaani подтверждает нашу приверженность созданию этичных и инклюзивных систем ИИ, основанных на разнообразии и представленности. Собрав более 8,000 часов речевых записей и расшифровав 800 часов, мы гордимся тем, что внесли свой вклад в один из самых дальновидных проектов цифровой инклюзии в Индии.
Поскольку проект Vaani продолжает двигаться к своей более масштабной цели — собрать более 150,000 XNUMX часов данных, мы готовы поддержать следующий рубеж инноваций в области искусственного интеллекта, который будет актуален для каждого индийца.
Хотите стать нашим партнером в создании искусственного интеллекта, который понимает реальный мир? www.shaip.com